模型在线服务 PAI-EAS

模型在线服务 PAI-EAS(Elastic AI Service)是阿里云面向大模型时代的云原生推理平台,支持将 LLM、AIGC、多模态及传统模型一键部署为推理服务或 Agentic AI 应用。深度集成 vLLM、SGLang 等主流引擎,提供智能路由、模型缓存加速、KVCache、算力容错等核心能力,助力企业低成本构建高性能 Agent 应用。

产品优势

极速部署
支持模板部署/自定义部署,快速部署 Qwen、DeepSeek、GLM、MiniMax 等主流大模型
推理加速
集成vLLM、SGLang等推理引擎;智能路由动态调度;模型缓存加速大模型加载
异构算力
支持GPU/CPU等异构资源,提供公共资源组、专属资源组与资源配额,灵活匹配Agentic AI业务需求
智能弹性
支持基于QPS、GPU利用率等指标自动扩缩容,缩容至0,高效支持Agentic AI应对流量波动
稳定可靠
GPU异常检测与容错;专属资源物理隔离;故障自愈与灰度发布,保障AI生产级稳定性
企业级网络
ALB专属网关支持独享资源、VPC隔离与SSE流式传输,灵活满足Agent的公网/内网访问

产品功能

云原生大模型推理平台,一键部署 Agentic AI 与多模态应用,推理性能领先,成本更优。
推理加速层面向大模型与 Agentic AI 的推理加速层,深度优化性能与成本,让模型跑得更快、更省钱。
LLM 智能路由基于 LLM 特有指标动态分发请求,支持前缀缓存、PD 分离等调度策略,均衡推理实例算力与显存分配,TTFT 最高降低 25%,集群吞吐显著提升;原生兼容 OpenAI 与 Anthropic API协议,无缝对接 Claude Code 等生态工具
模型缓存加速实测 DeepSeek-V3.2(643G)加载耗时从 12 分钟降至 2 分钟。通过本地缓存与预热缓存双机制,百 GB 级大模型加载提速 6-10 倍,显著缩短冷启动与扩容时间
KVCache 缓存基于多级池化 KV Cache 与 cache-aware 智能路由,复用历史对话、长文档等公共前缀,大幅降低首 token 延迟,节省 GPU 算力
主流推理引擎深度优化 vLLM、SGLang 等主流推理加速引擎,开箱即用,性能领先
模型部署层服务部署发布的多项能力,简化发布更新流程,保障服务高效稳定运行。
场景化模型部署内置 Qwen、DeepSeek、GLM、MiniMax 等主流大模型一键部署模板,支持 LLM、AIGC、Agent 等场景化方案
同步/异步推理支持实时同步推理(低延迟)、近实时异步推理(内置消息队列,适用于 AIGC、视频处理等长耗时任务)、离线批量推理三种模式
一键压测支持动态加压自动探测服务性能极限,实时查看秒级监控数据与压测报告,快速评估服务能力
灰度发布支持多个服务加入同一灰度群组,按比例分配流量至新版本进行验证,保障安全上线
流量镜像将线上流量按比例复制到测试服务进行可靠性验证,不影响真实用户请求
实时监控告警提供 QPS、响应时长、CPU/GPU 利用率等关键指标的实时监控与告警,全面掌握服务运行状态
版本管理支持服务版本快速切换与回滚,保障业务连续性
网络接入层企业级网络接入能力,提供独享资源、灵活访问与安全保障。
应用型专属网关(ALB)提供独享网络资源、灵活访问控制和高性能转发能力,推荐生产环境使用,具备更好的性能、稳定性与扩展性
关联负载均衡(NLB)调用支持将 EAS 服务挂载至网络型负载均衡(NLB)实例,通过 VPC 高速直连统一管理和调度服务流量,提供强大的访问控制与负载均衡能力,适用于高流量服务场景
自定义域名支持绑定企业自有域名,配合 SSL 证书实现 HTTPS 加密访问,提升品牌一致性与安全性
多种调用方式支持 RESTful API、gRPC、WebSocket 等多种调用方式,覆盖在线推理、流式输出等场景
容器调度层通过智能扩缩容与资源池化,帮助客户在业务波峰波谷中高效管理资源,降本增效。
水平自动扩缩容基于 QPS、CPU/GPU 利用率、异步队列长度等多维指标自动调整副本数量,支持自定义指标,精准匹配业务负载
缩容至 0闲时自动将副本数缩容至 0,按实际用量付费,零成本待机,新请求到达时秒级唤醒
定时扩缩容业务负载可预估的场景下,按预设时间策略自动扩缩容,提前应对业务高峰,避免资源浪费
弹性资源池专属资源组用满时,自动将新增实例溢出到公共资源组按量计费机器上,兼顾成本与稳定性
算力检测与容错自动检测 GPU 算力、节点通信等资源健康状态,识别故障节点与慢节点,保障大规模分布式推理服务稳定运行
故障自愈实例异常自动重建,请求自动重新调度,保障服务连续性
基础设施层支持异构硬件(CPU/GPU/灵骏智算)的基础设施,配合 AI 专属机型与抢占型实例帮助降本增效。
GPU 算力全面覆盖多种主流 GPU 规格,满足多样化算力需求;同时提供自研高性价比 GPU 实例,成本最高可降低 45%
灵骏智算资源面向大模型与多机分布式推理场景,提供高性能 RDMA 网络互联,支持千亿参数级模型的分布式部署
抢占型实例(Spot)PAI-EAS 全面接入 Spot Instance 抢占型实例,最高降本 90%,适合离线批量推理、AIGC 生成等容错场景
专属资源组提供物理隔离的专属资源,无资源抢占风险,适合对稳定性与性能有高要求的核心业务
公共资源组按量付费,开箱即用,适合开发测试、小规模业务及成本敏感场景

产品规格

全面支持 LLM、多模态等大模型一键部署与高性能推理,内置推理加速引擎与分布式推理能力,搭配高性价比规格与 Spot 抢占式实例,推理成本最高可降低 90%

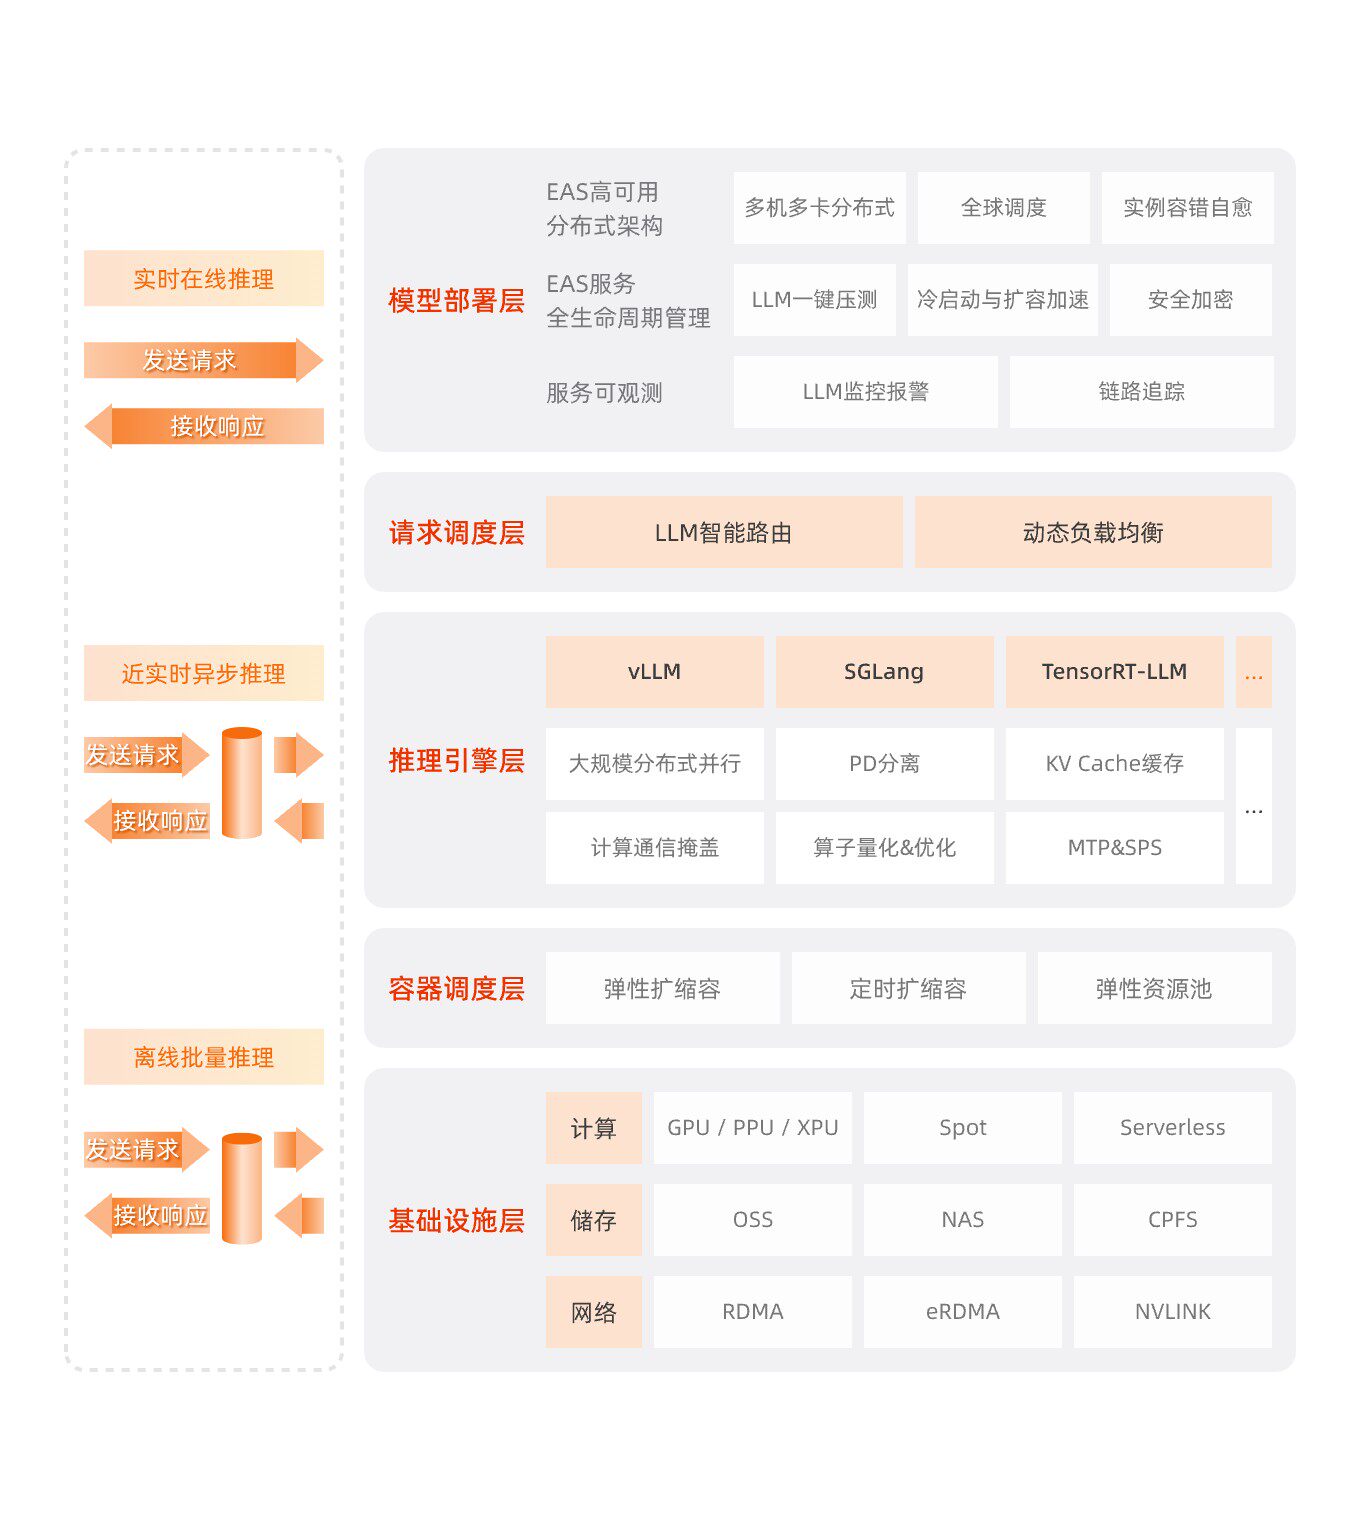
产品架构

模型推理
模型在线服务 PAI-EAS(Elastic Al Service)是面向 大模型与 Agentic AI 时代 的一站式推理服务平台,支持 LLM、多模态、MoE 等模型一键部署为在线推理服务,内置主流推理加速引擎与弹性伸缩能力,全面覆盖实时、异步与批量等多种推理场景。
推理能力
实时同步推理
适用于 Agentic AI、智能对话、个性化搜索推荐等高吞吐、低延迟场景,支持 LLM 智能路由与动态负载均衡,保障线上业务稳定运行。
近实时异步推理
适用于 AIGC 文生图/视频、多模态内容生成等耗时任务,内置消息队列,支持按需弹性扩缩容、免运维。
离线批量推理
基于 LLM 特有指标(KV Cache、请求队列等)动态调度请求,支持前缀缓存、PD 分离等策略,TTFT 降低 25%,吞吐提升 5%+,原生兼容 OpenAI 与 Anthropic API(Claude Code 等工具无缝对接)。
相关产品

帮助文档