立即开始
了解如何基于真武超节点实例训练模型,部署推理任务
超节点架构
64 卡全带宽互联 · HPN8.0 支持 12 万卡集群
万亿参数模型训推
高带宽、低时延芯片互联,超大规模集群扩展能力
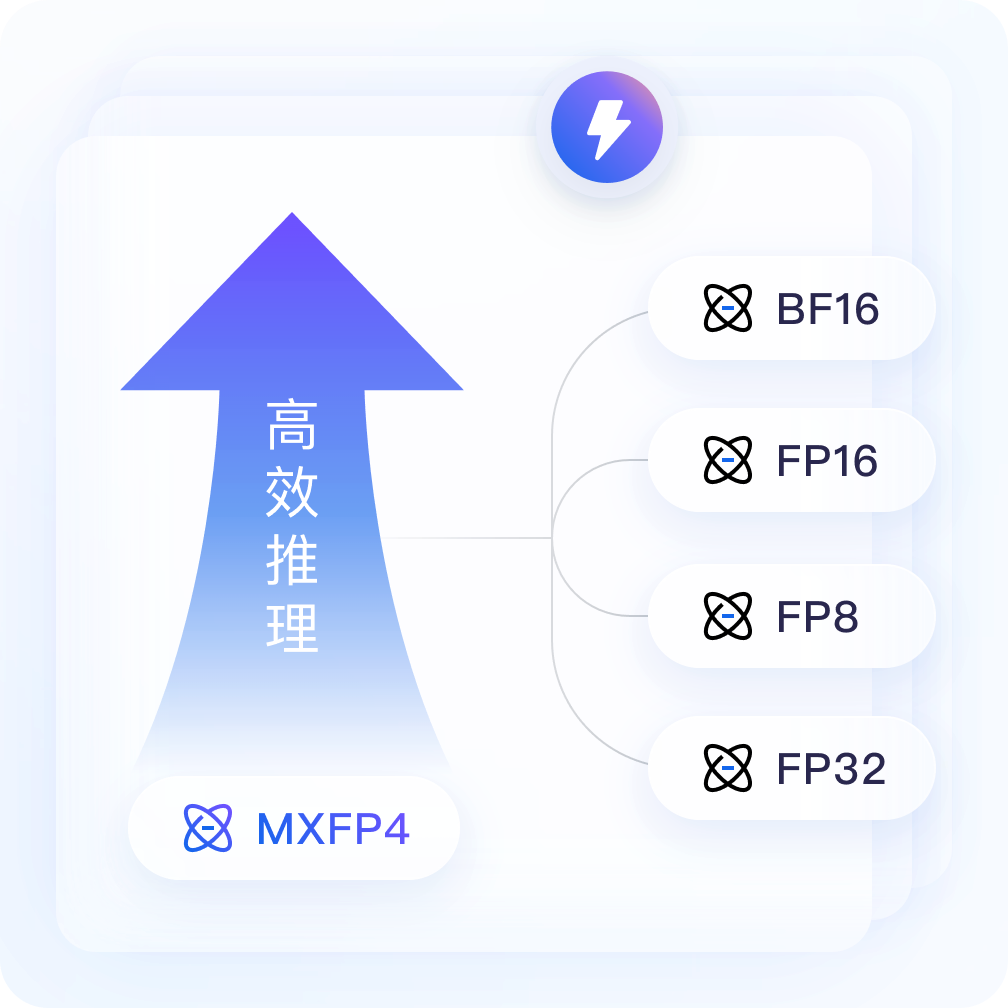
MXFP4 精度支持
新增 MXFP4 精度,兼容 FP8 / BF16 / FP16 / FP32
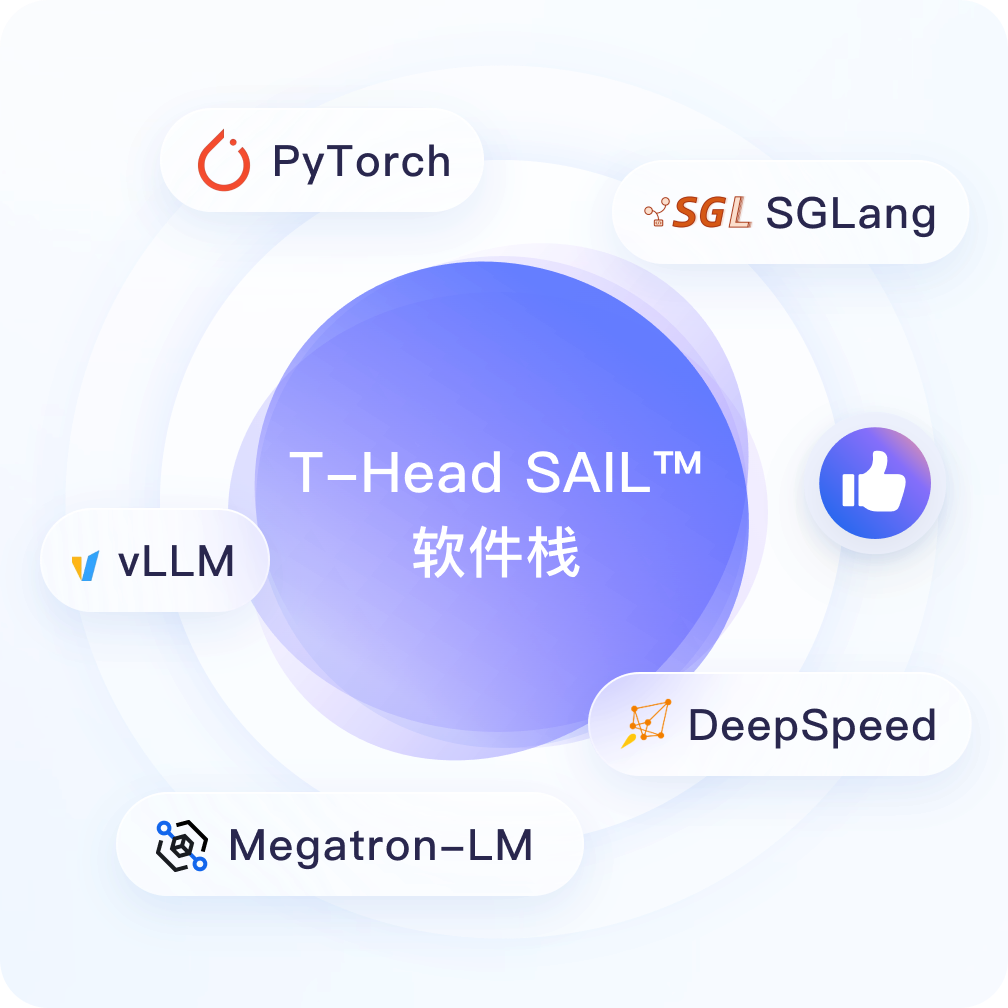
主流生态兼容
全面兼容主流 AI 生态,业务代码无需修改
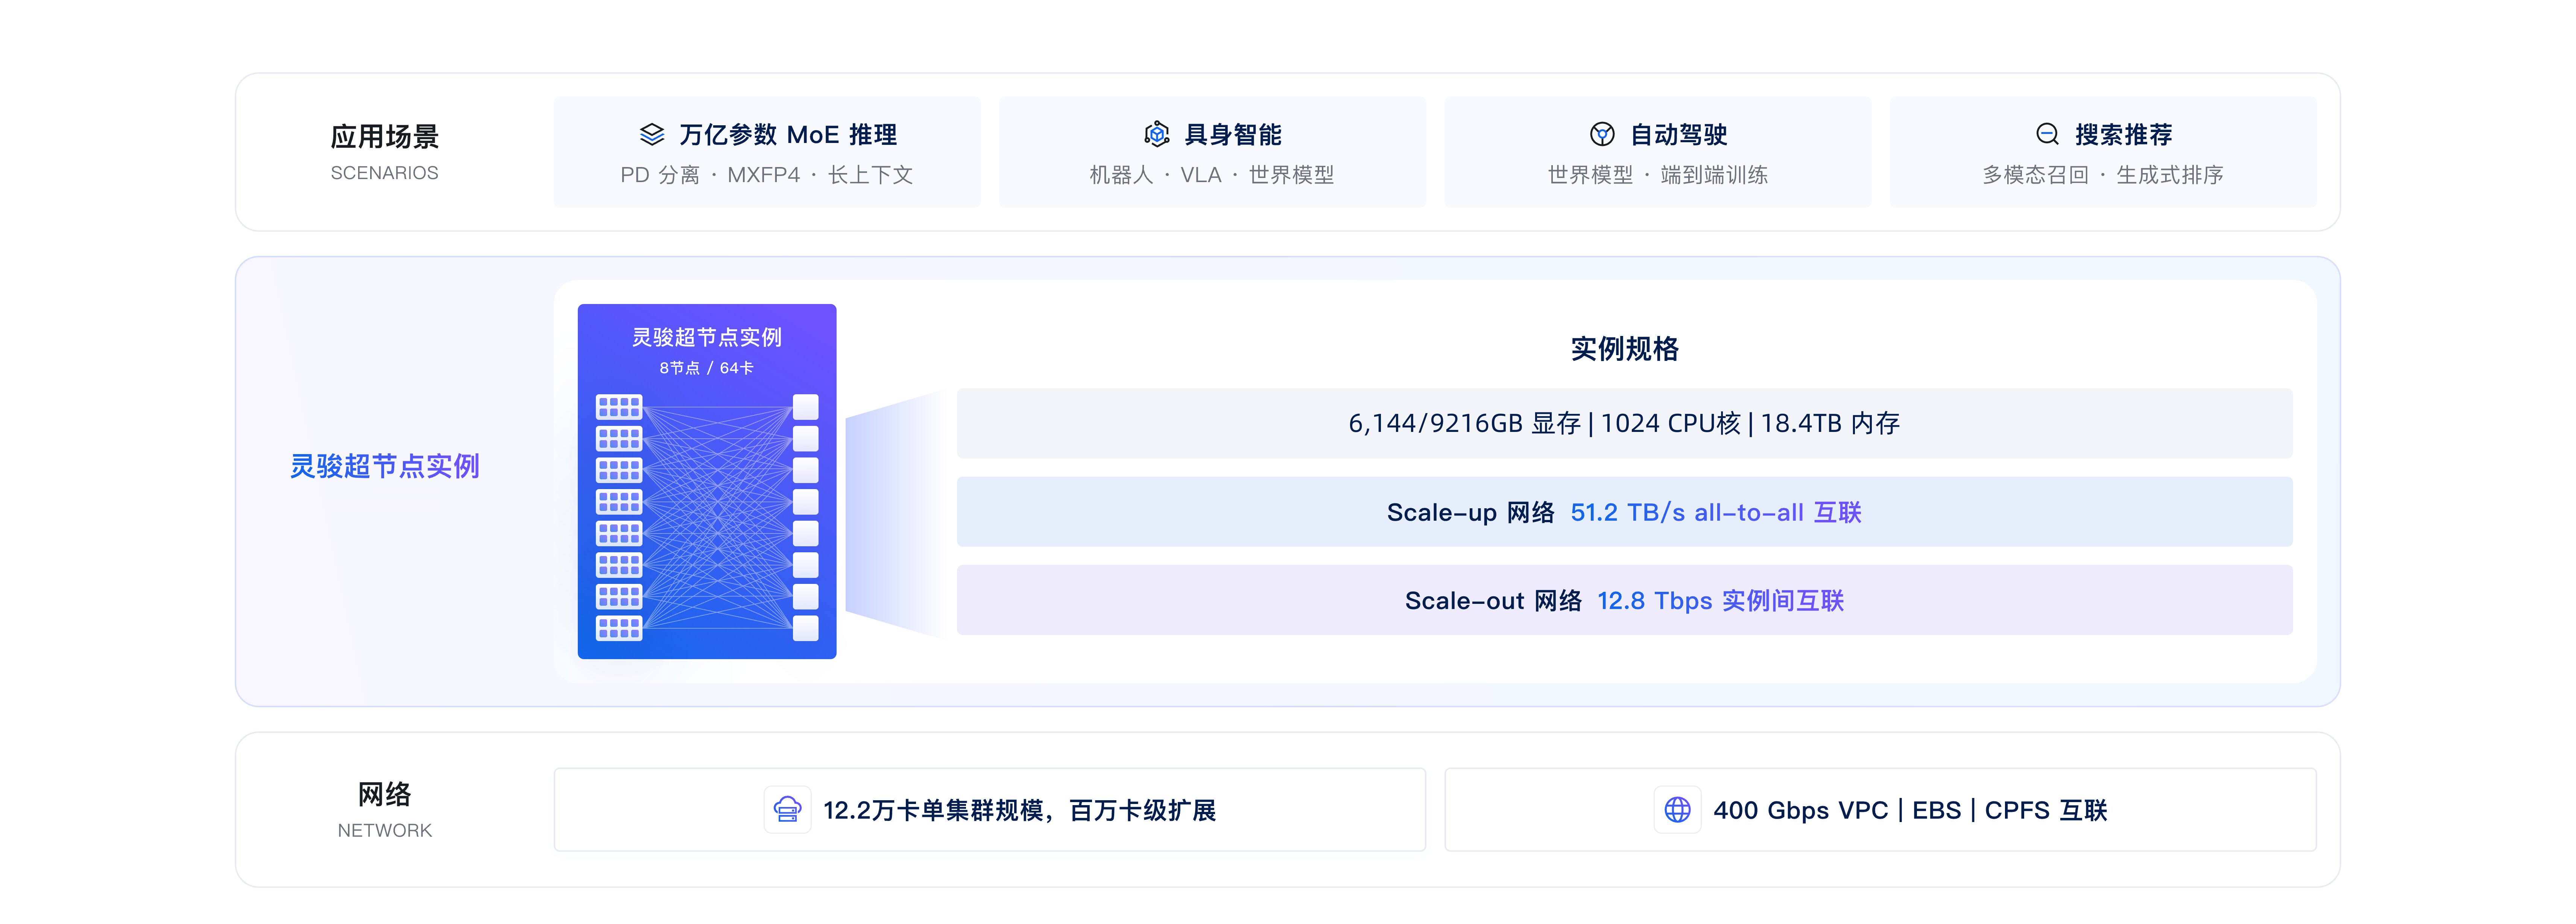
最新实例由真武M890芯片提供支持
实例 | efg2.P16EN(810E) | efg3.GP9AS(M890L) | efg3.GP9A(M890P) |
|---|
芯片代际 | 真武 810E(PPU 1.1) | 真武 M890L(PPU 1.5) | 真武 M890P(PPU 1.5) |
显存容量 | 1536 GB | 6144 GB | 9216 GB |
支持精度 | FP32 / BF16 / INT8 | FP32 / FP16 / BF16 / FP8 / MXFP4 | FP32 / FP16 / BF16 / FP8 / MXFP4 |
CPU | 96 核 | 1024 核 | 1024 核 |
内存 | 2 TB | 18.4 TB | 18.4 TB |
本地存储 | 15.36 TB NVMe + 960 GB SATA SSD | 122.88 TB NVMe | 122.88 TB NVMe |
前端网络 | 400 Gbps | 3.2 Tbps | 3.2 Tbps |
Scale-up 卡间互联 | 11.2 TB/s | 51.2 TB/s | 51.2 TB/s |
Scale-out 实例间互联 | 1.6 Tbps | 12.8 Tbps | 12.8 Tbps |
每实例 GPU | 16 卡 | 64 卡 | 64 卡 |
最小售卖单元 | 裸金属(16 卡) | 超节点(64 卡 / 8 节点) | 超节点(64 卡 / 8 节点) |
开服地域 | 北京、杭州、上海、乌兰察布 | 中卫(邀测中) | 乌兰察布(可用区 D),中卫(邀测中) |
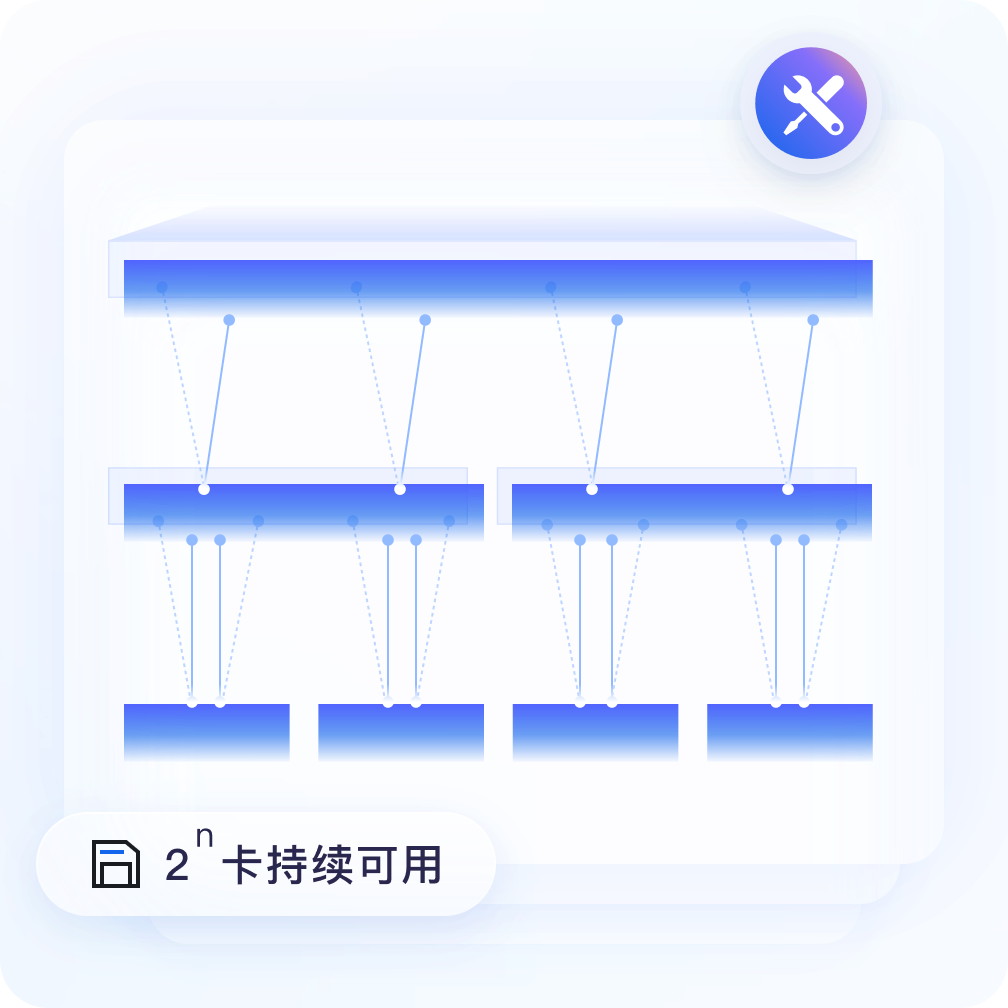
超节点架构故障自愈
面向 ICN64 超节点架构,支持故障自愈能力,2^n卡持续可用。
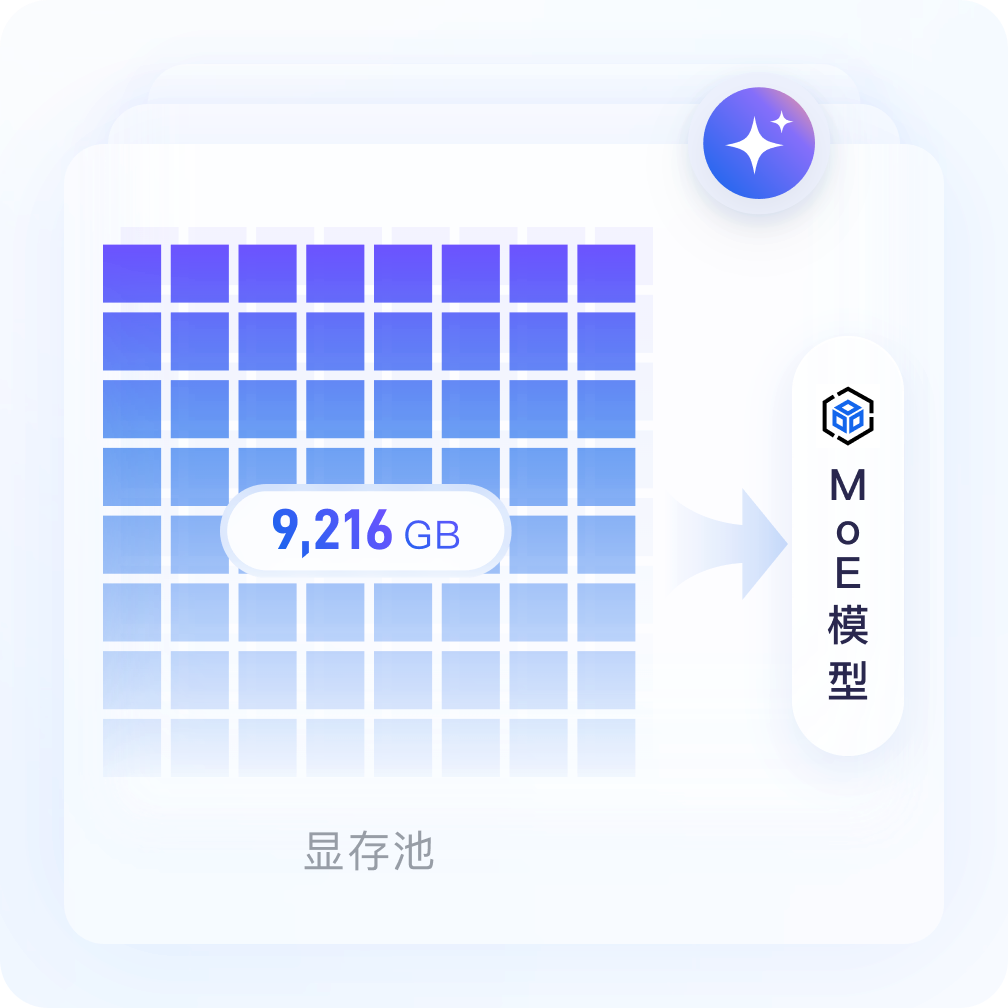
万亿参数MoE模型训推
每卡 144 GB 显存,实例 64 卡共 9,216 GB 显存池,承载万亿参数级模型。
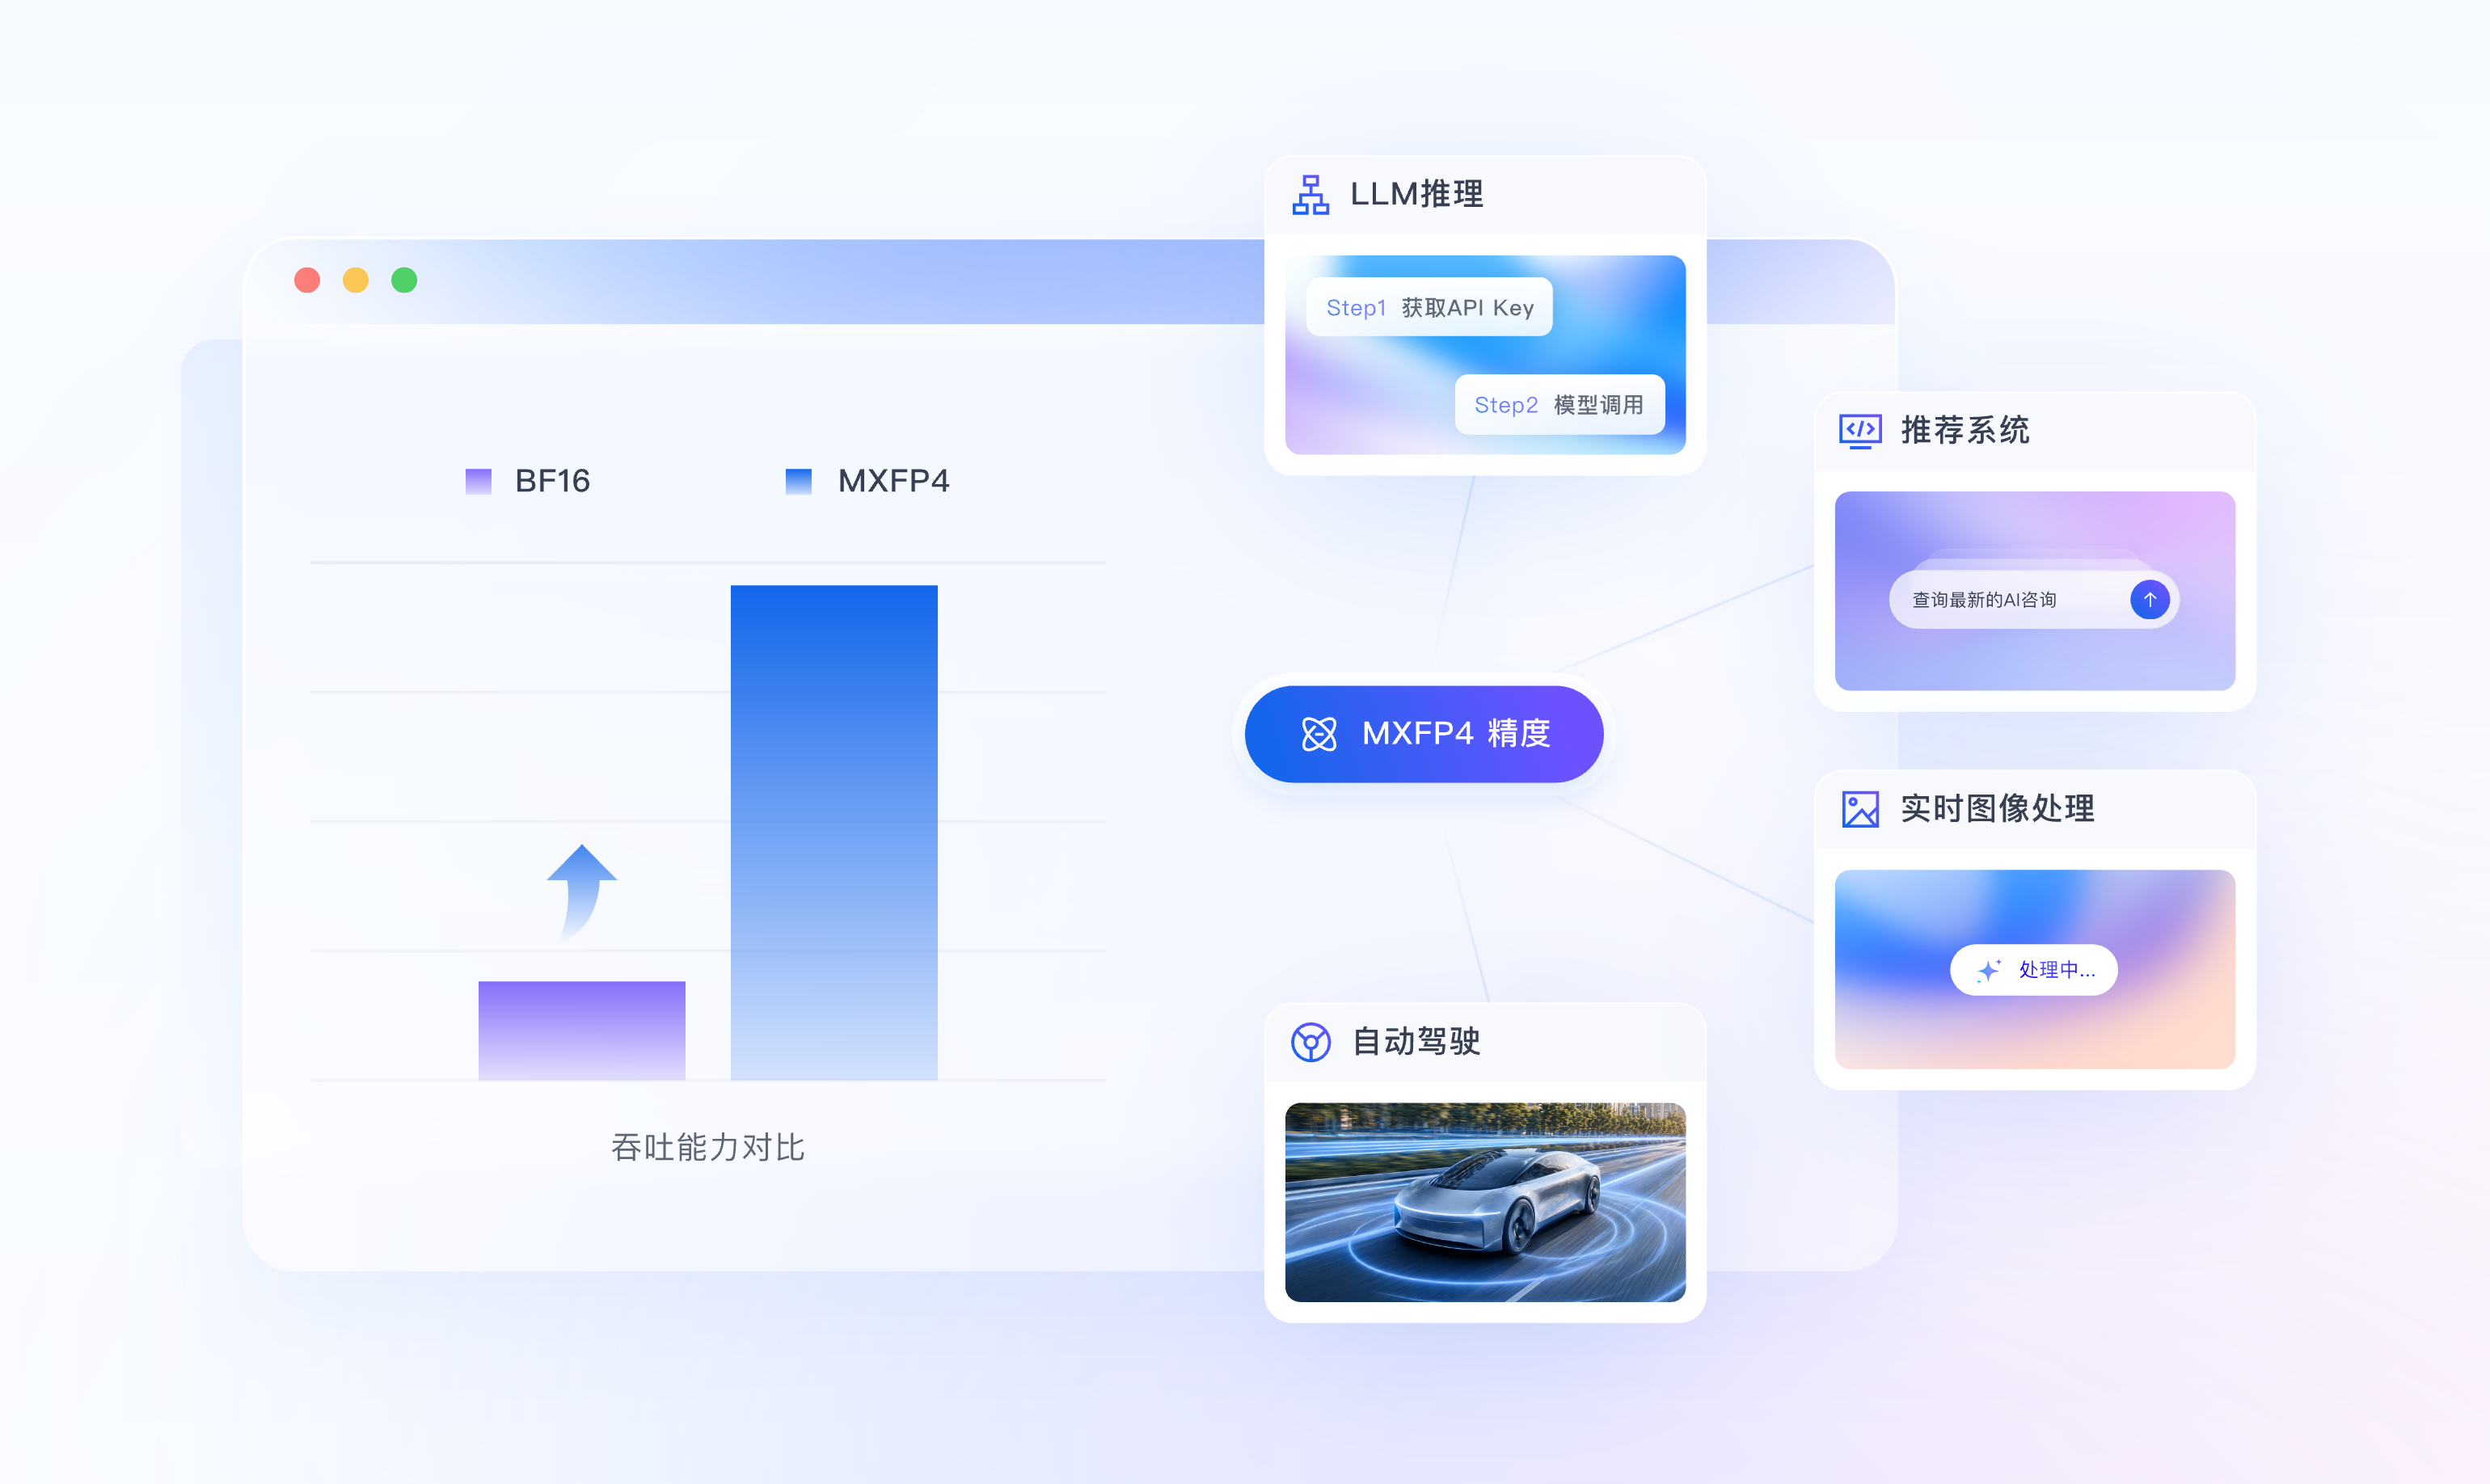
MXFP4 高效推理
新增 MXFP4 精度,相比 BF16 可提供数倍吞吐提升,适用于 LLM 推理、推荐系统等追求极致吞吐的场景。同时兼容 BF16 / FP16 / FP8 / FP32。
主流生态全兼容
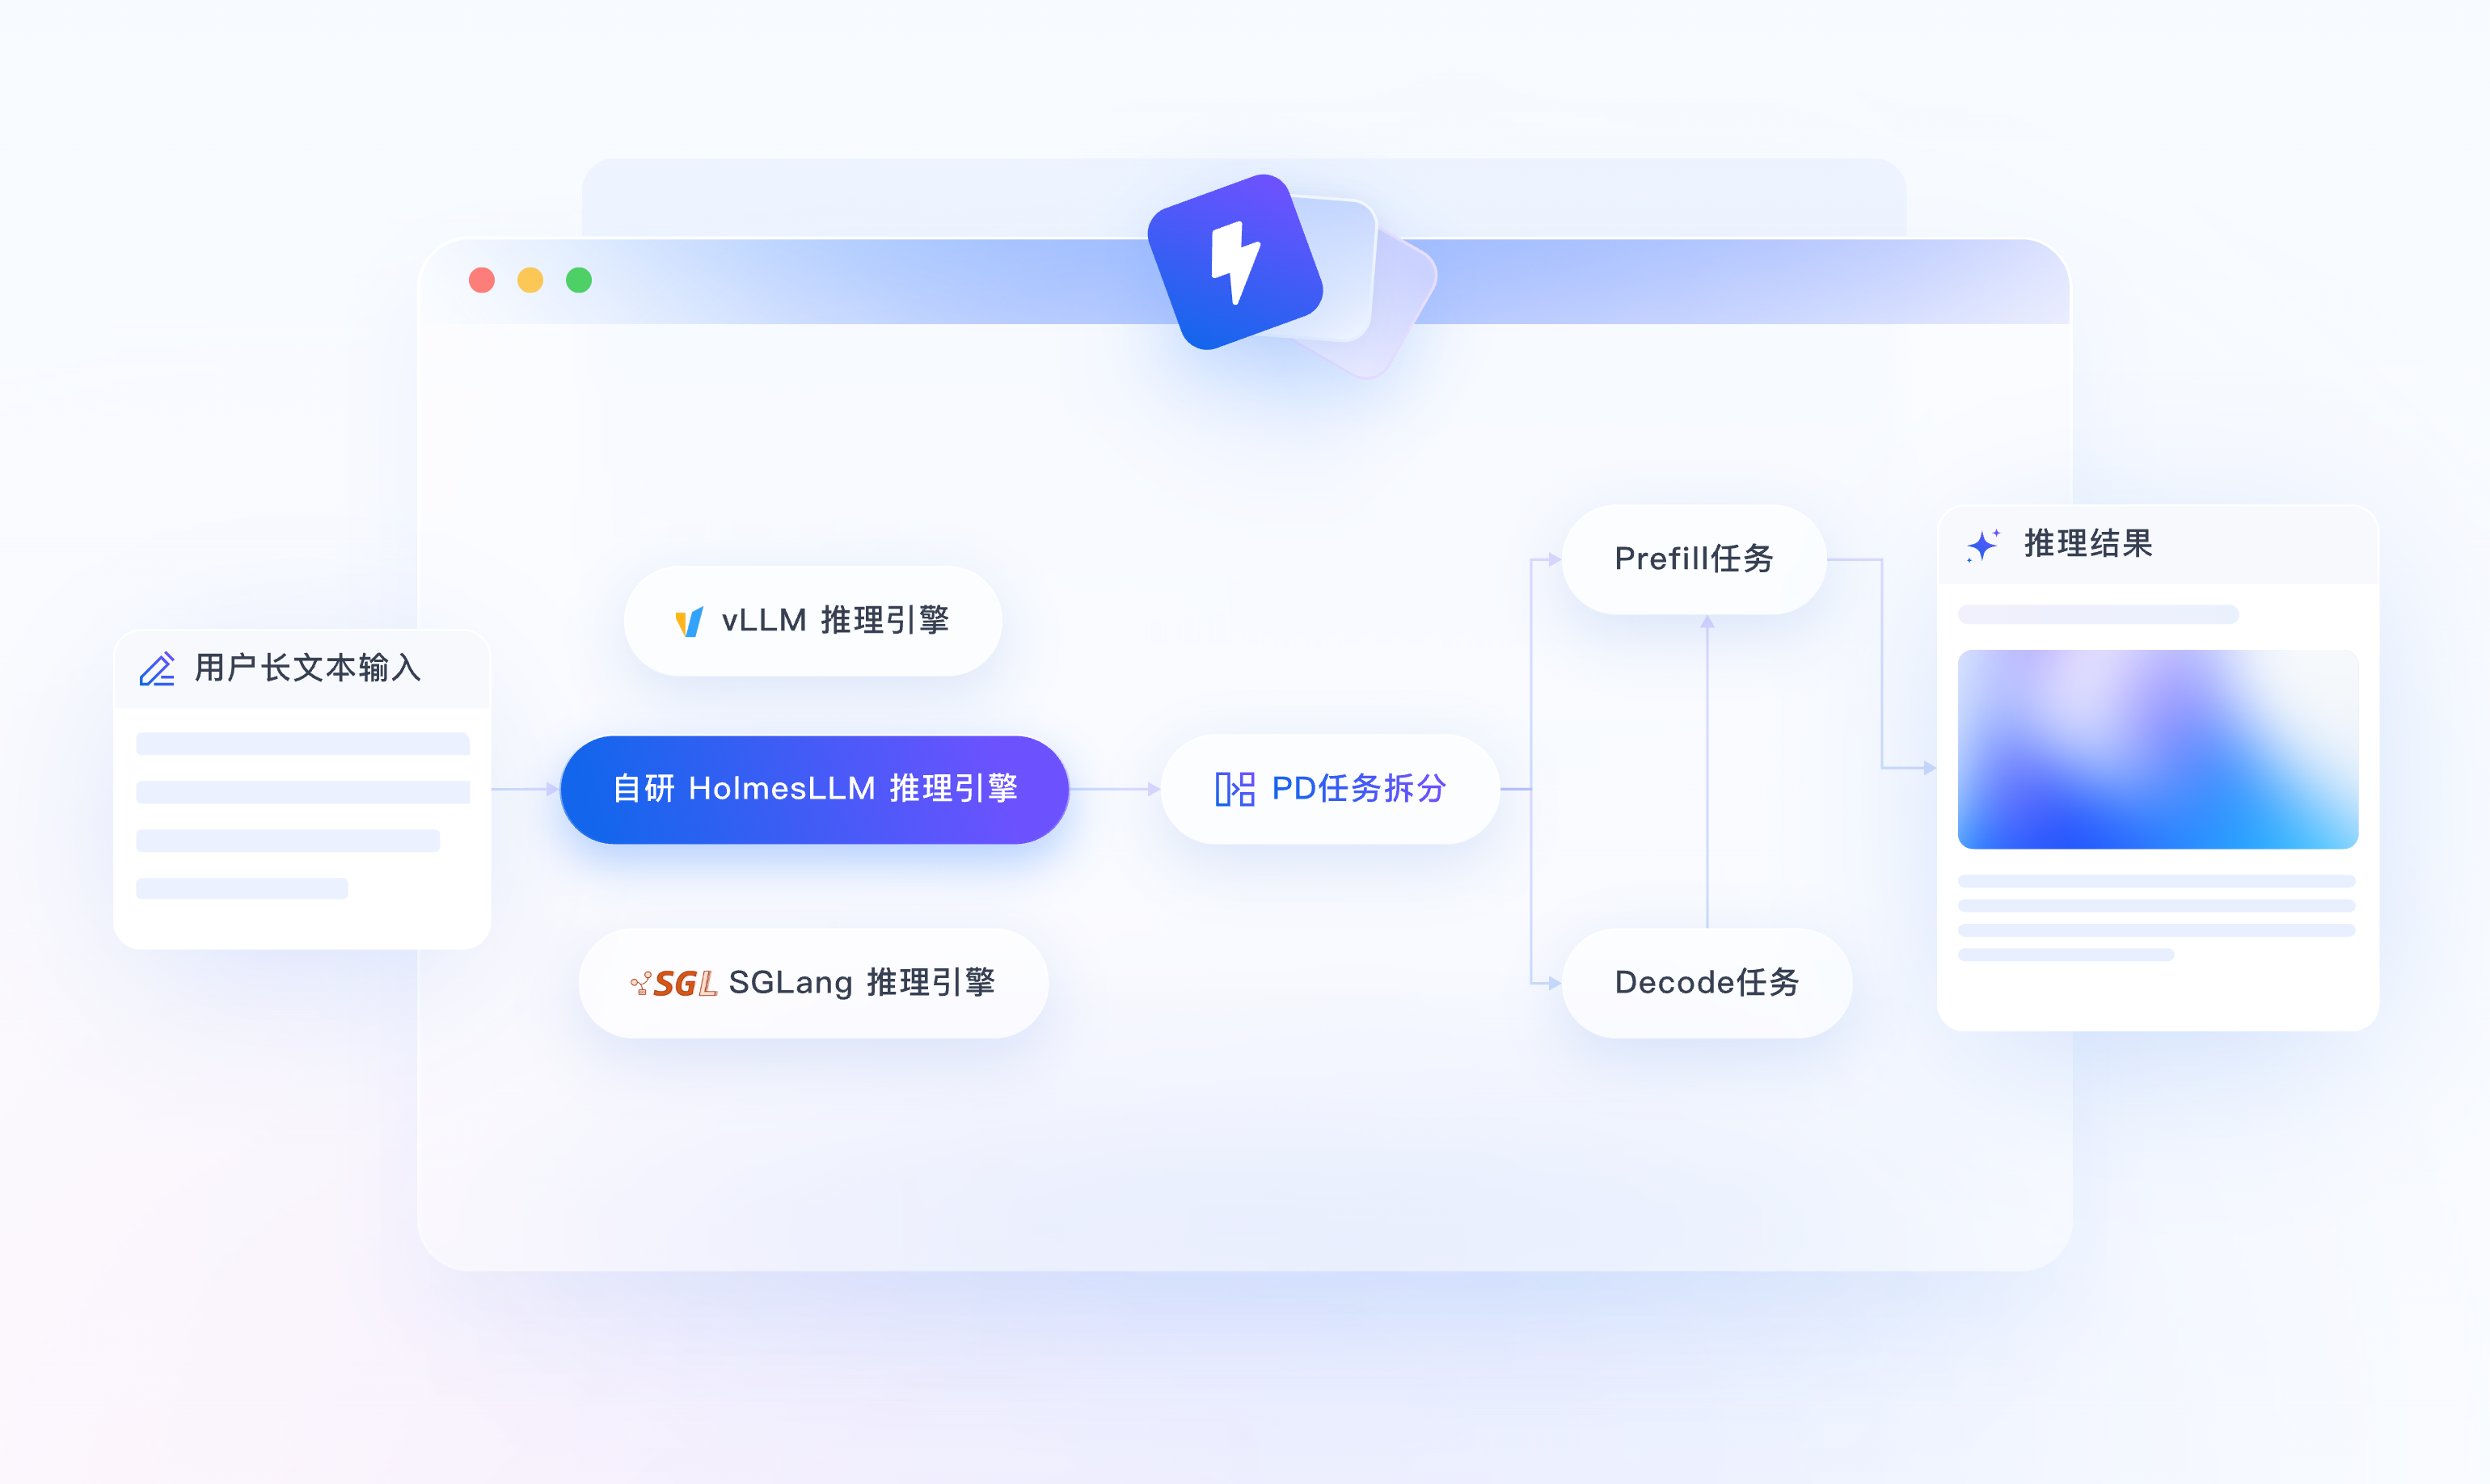
T-Head SAIL™ 软件栈(Interface / SDK / OS 三层架构)全面兼容主流 AI 生态,业务迁移零代码修改。PyTorch / vLLM / SGLang / Megatron-LM / DeepSpeed 开箱即用。
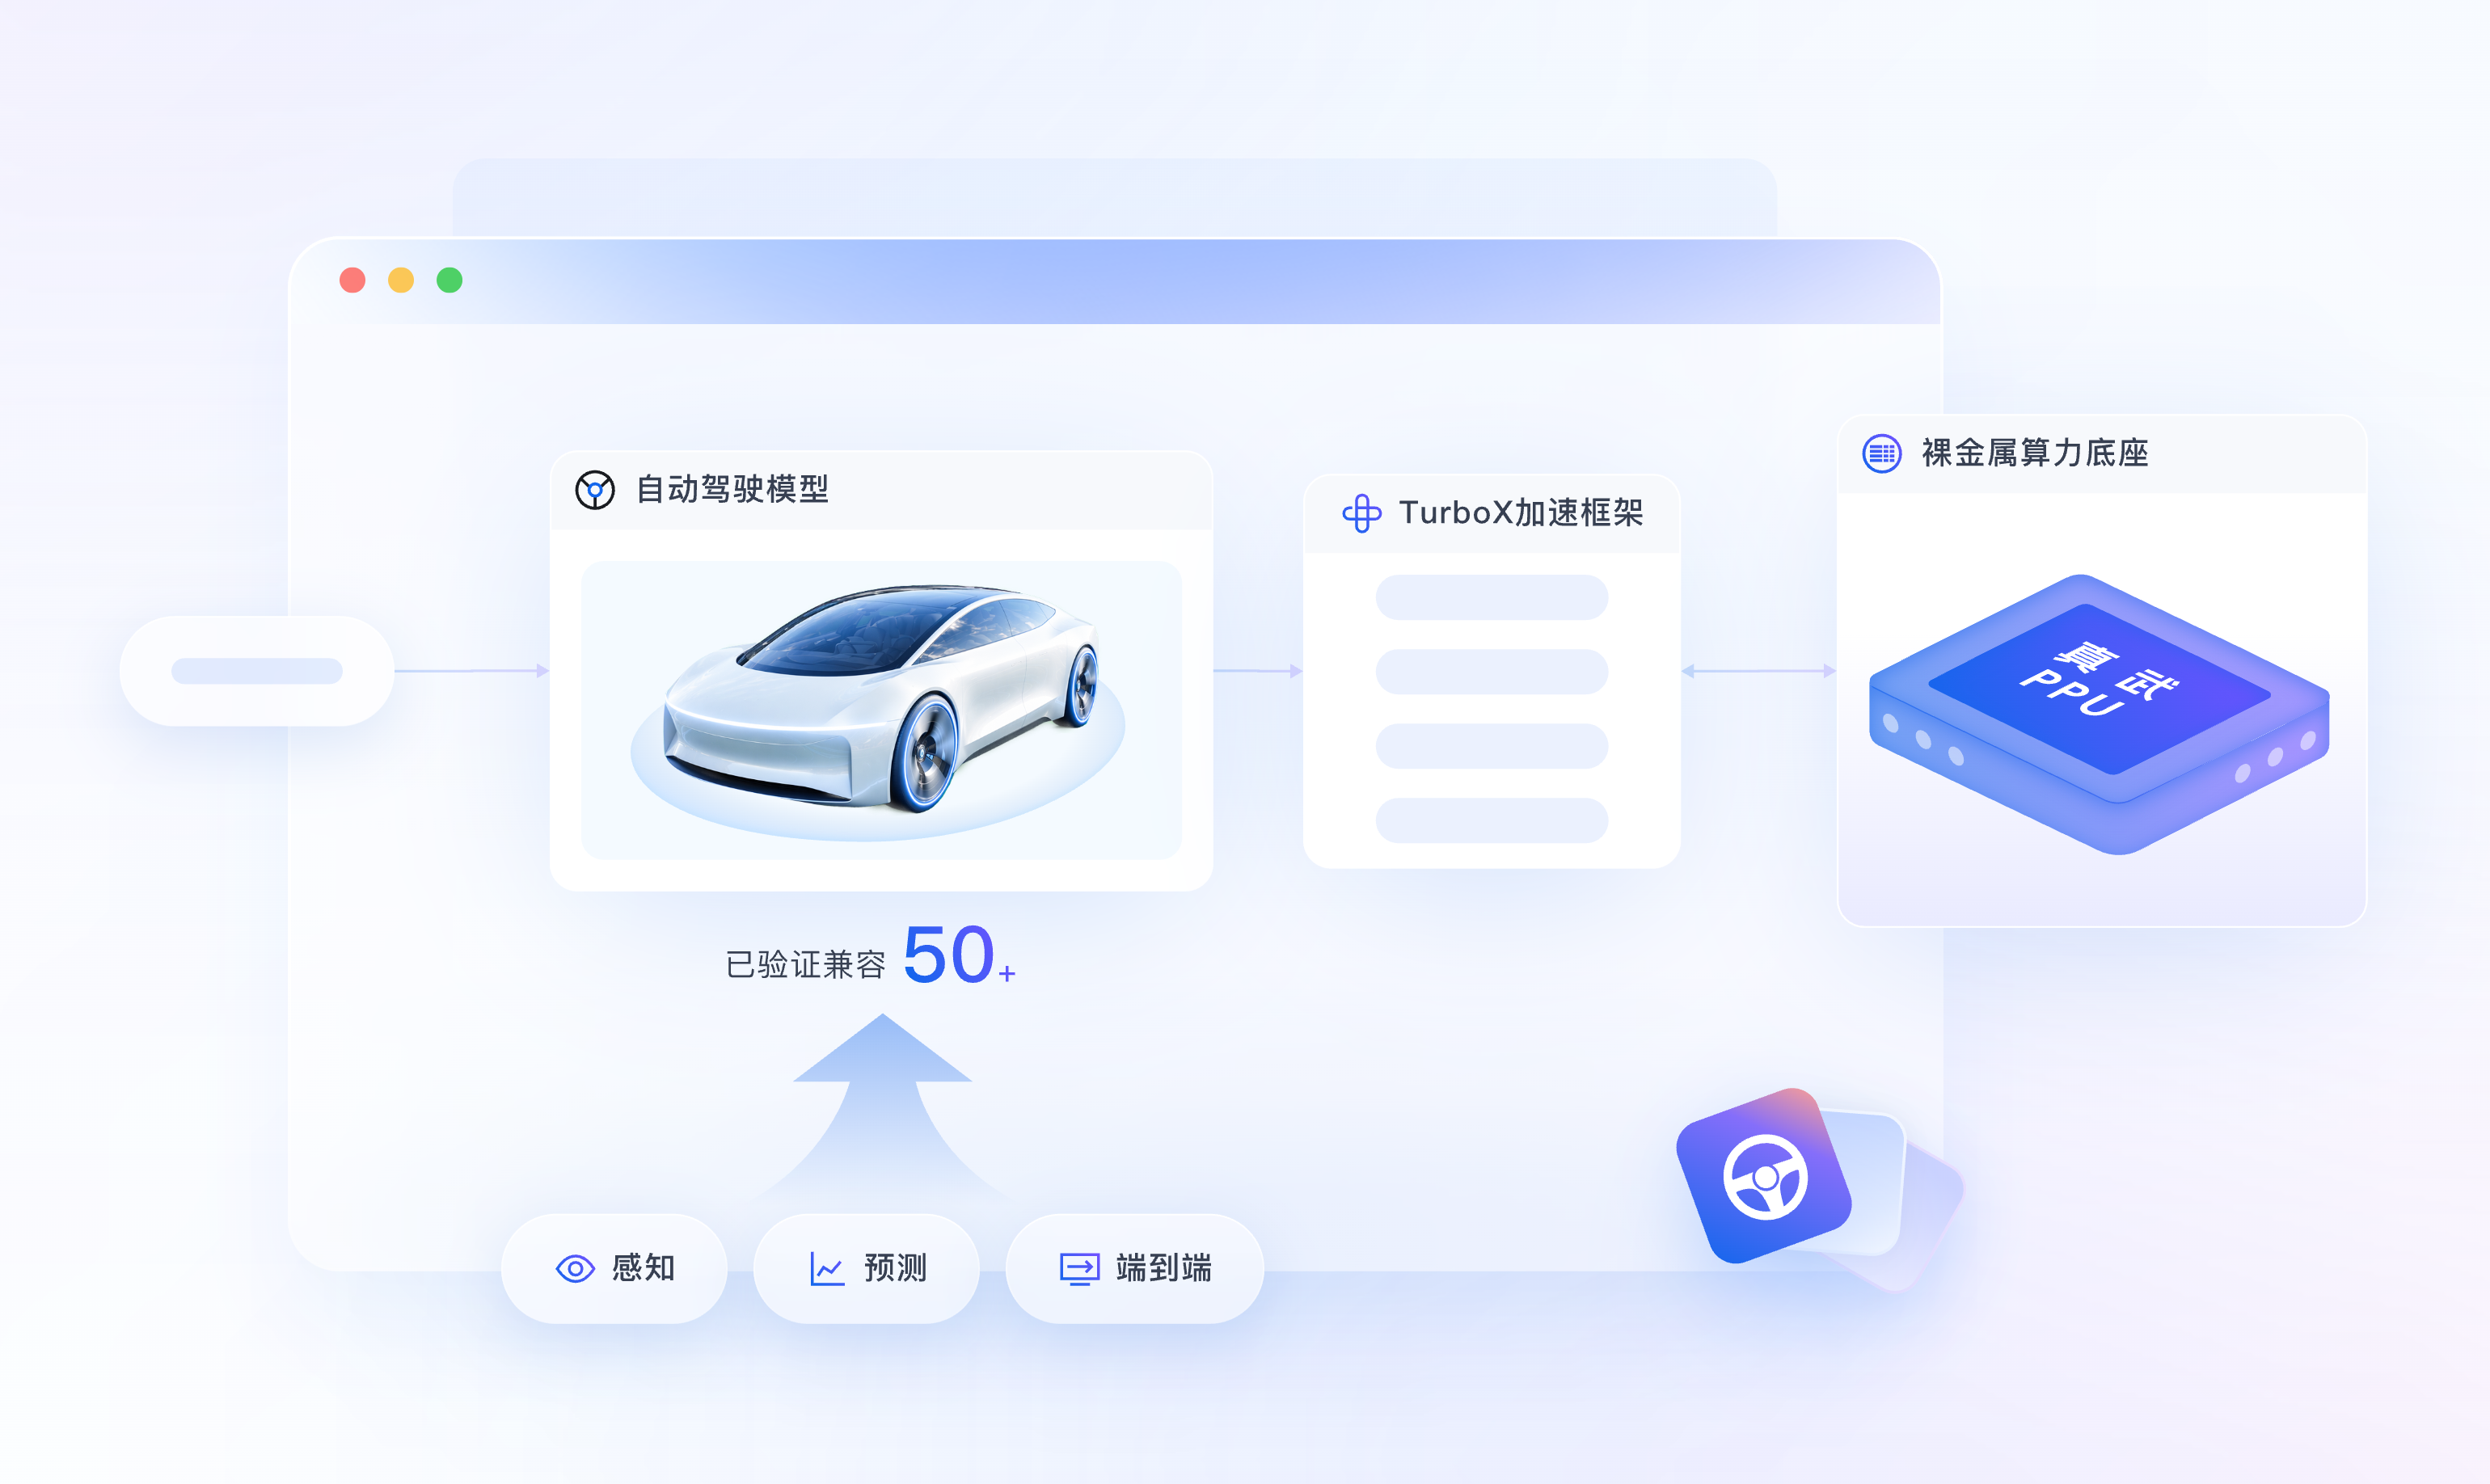
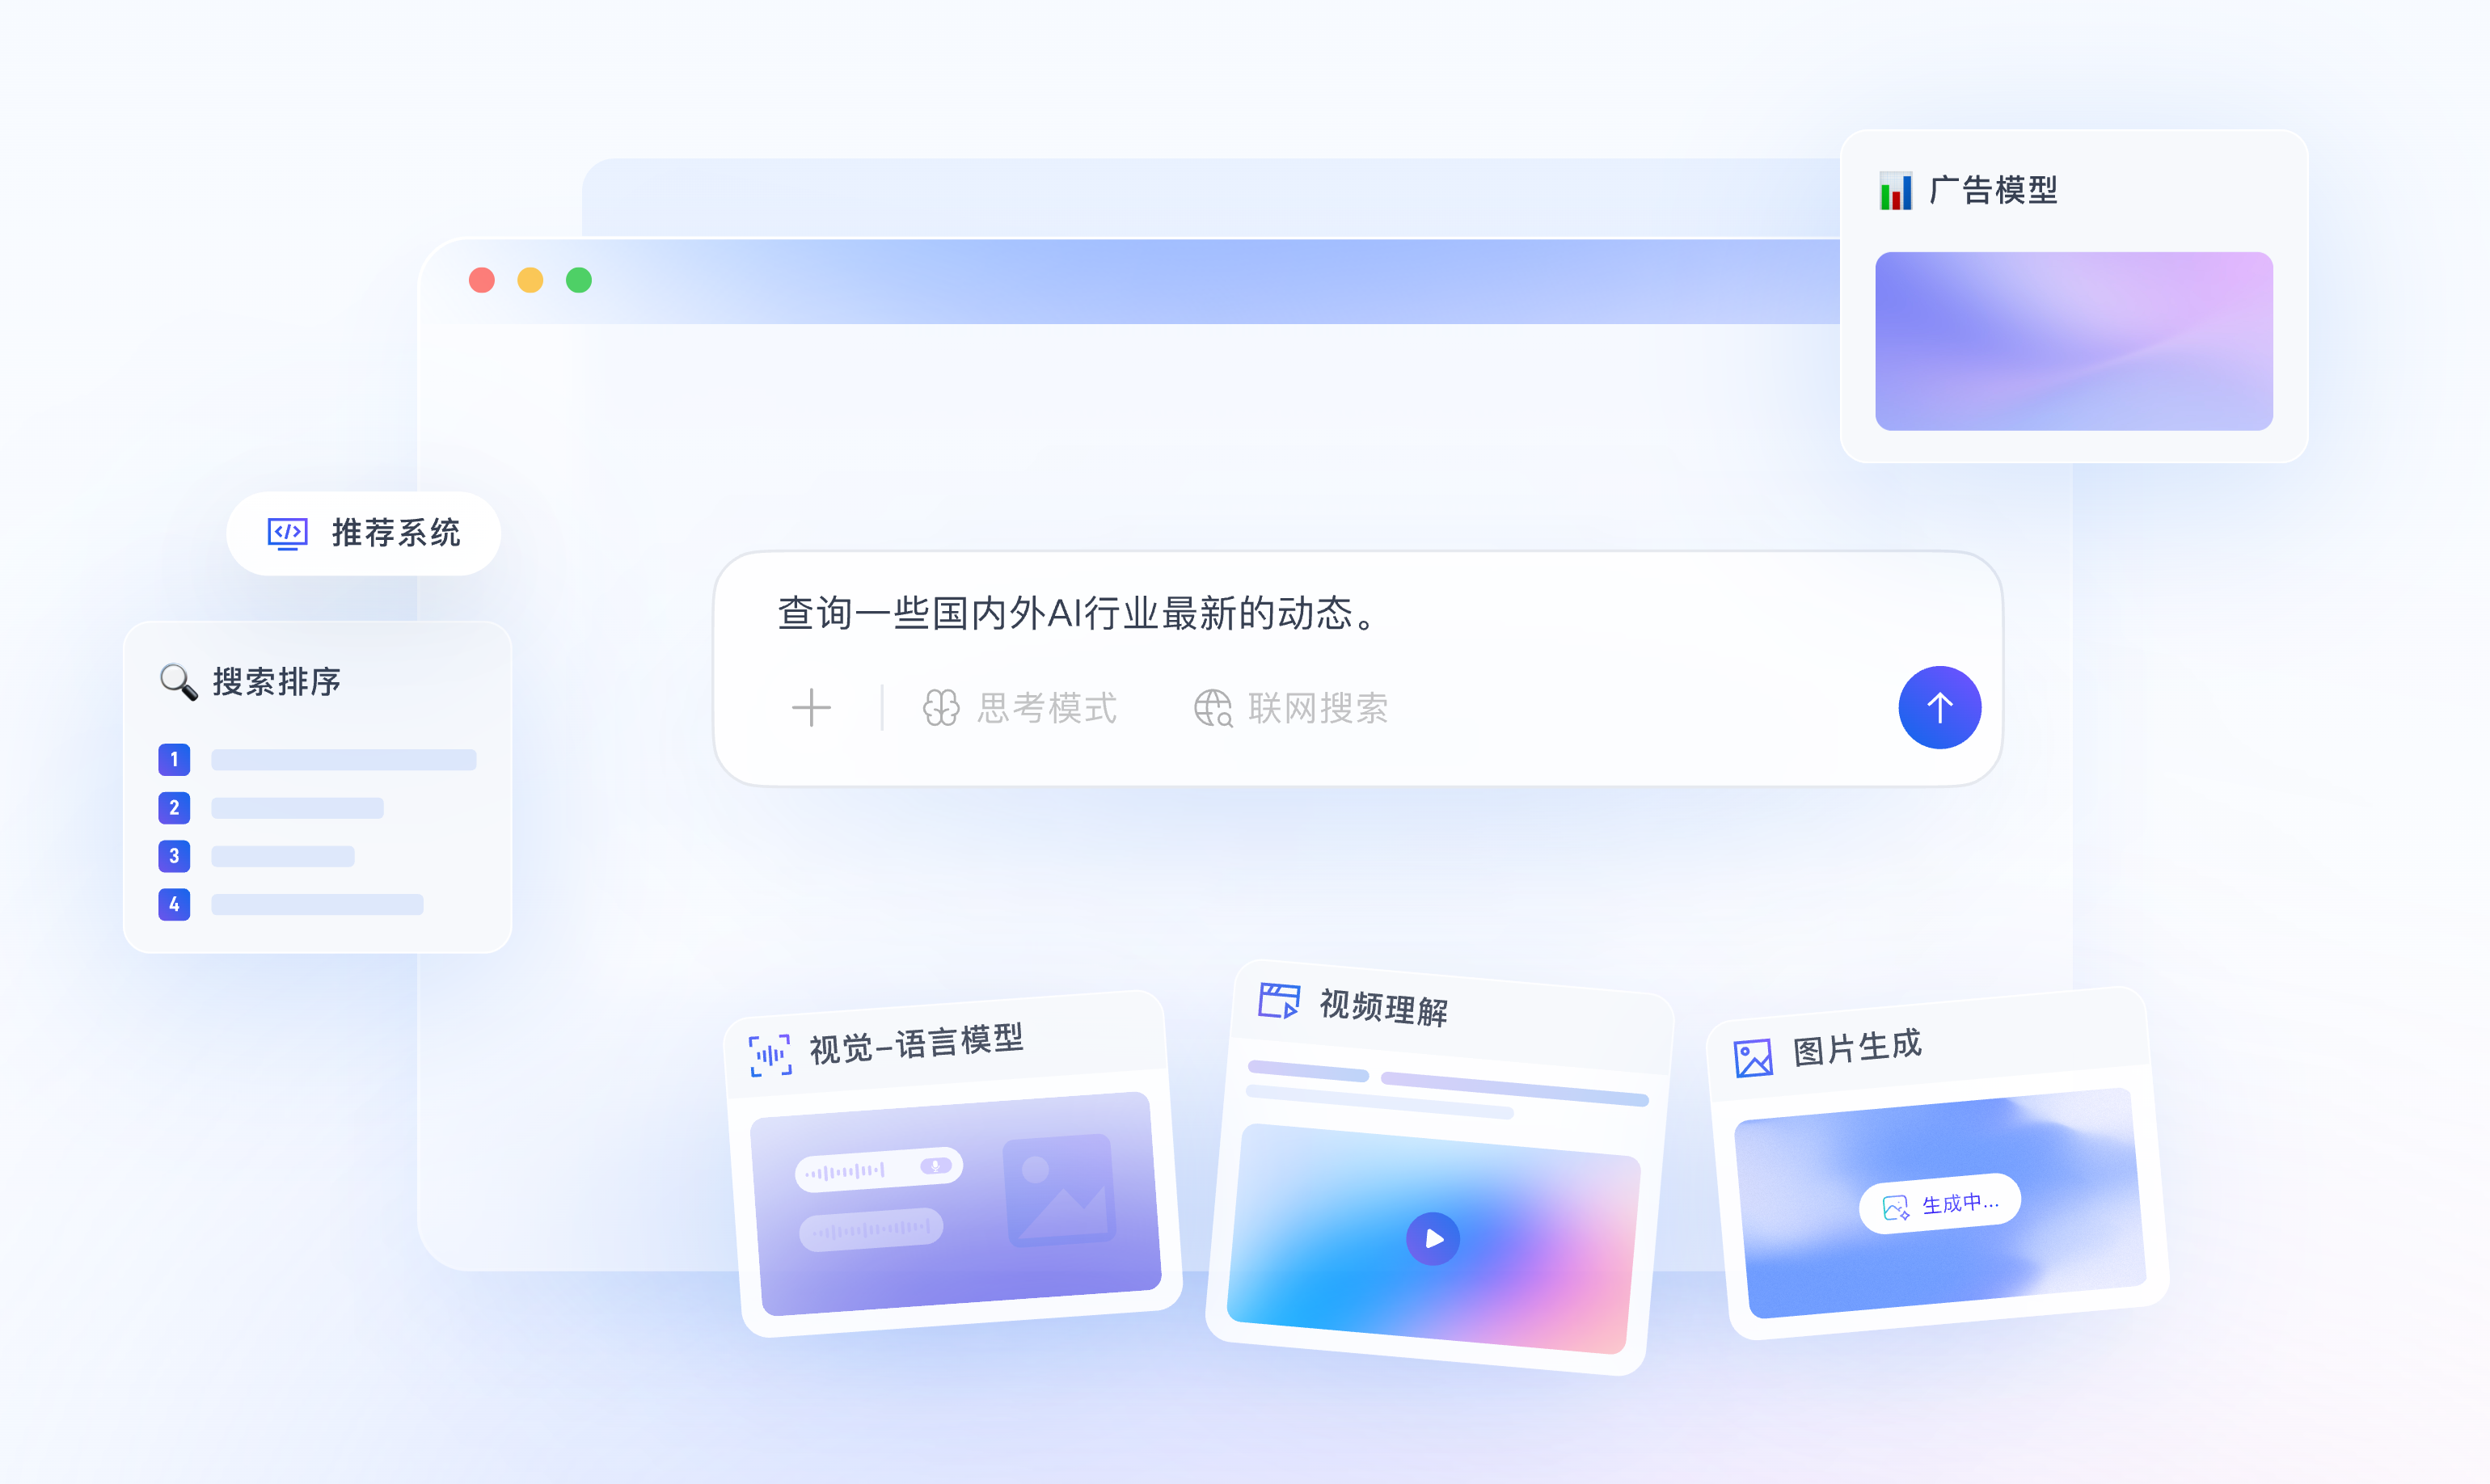
覆盖从大模型训练到自动驾驶的全场景 AI 工作负载。