产品介绍
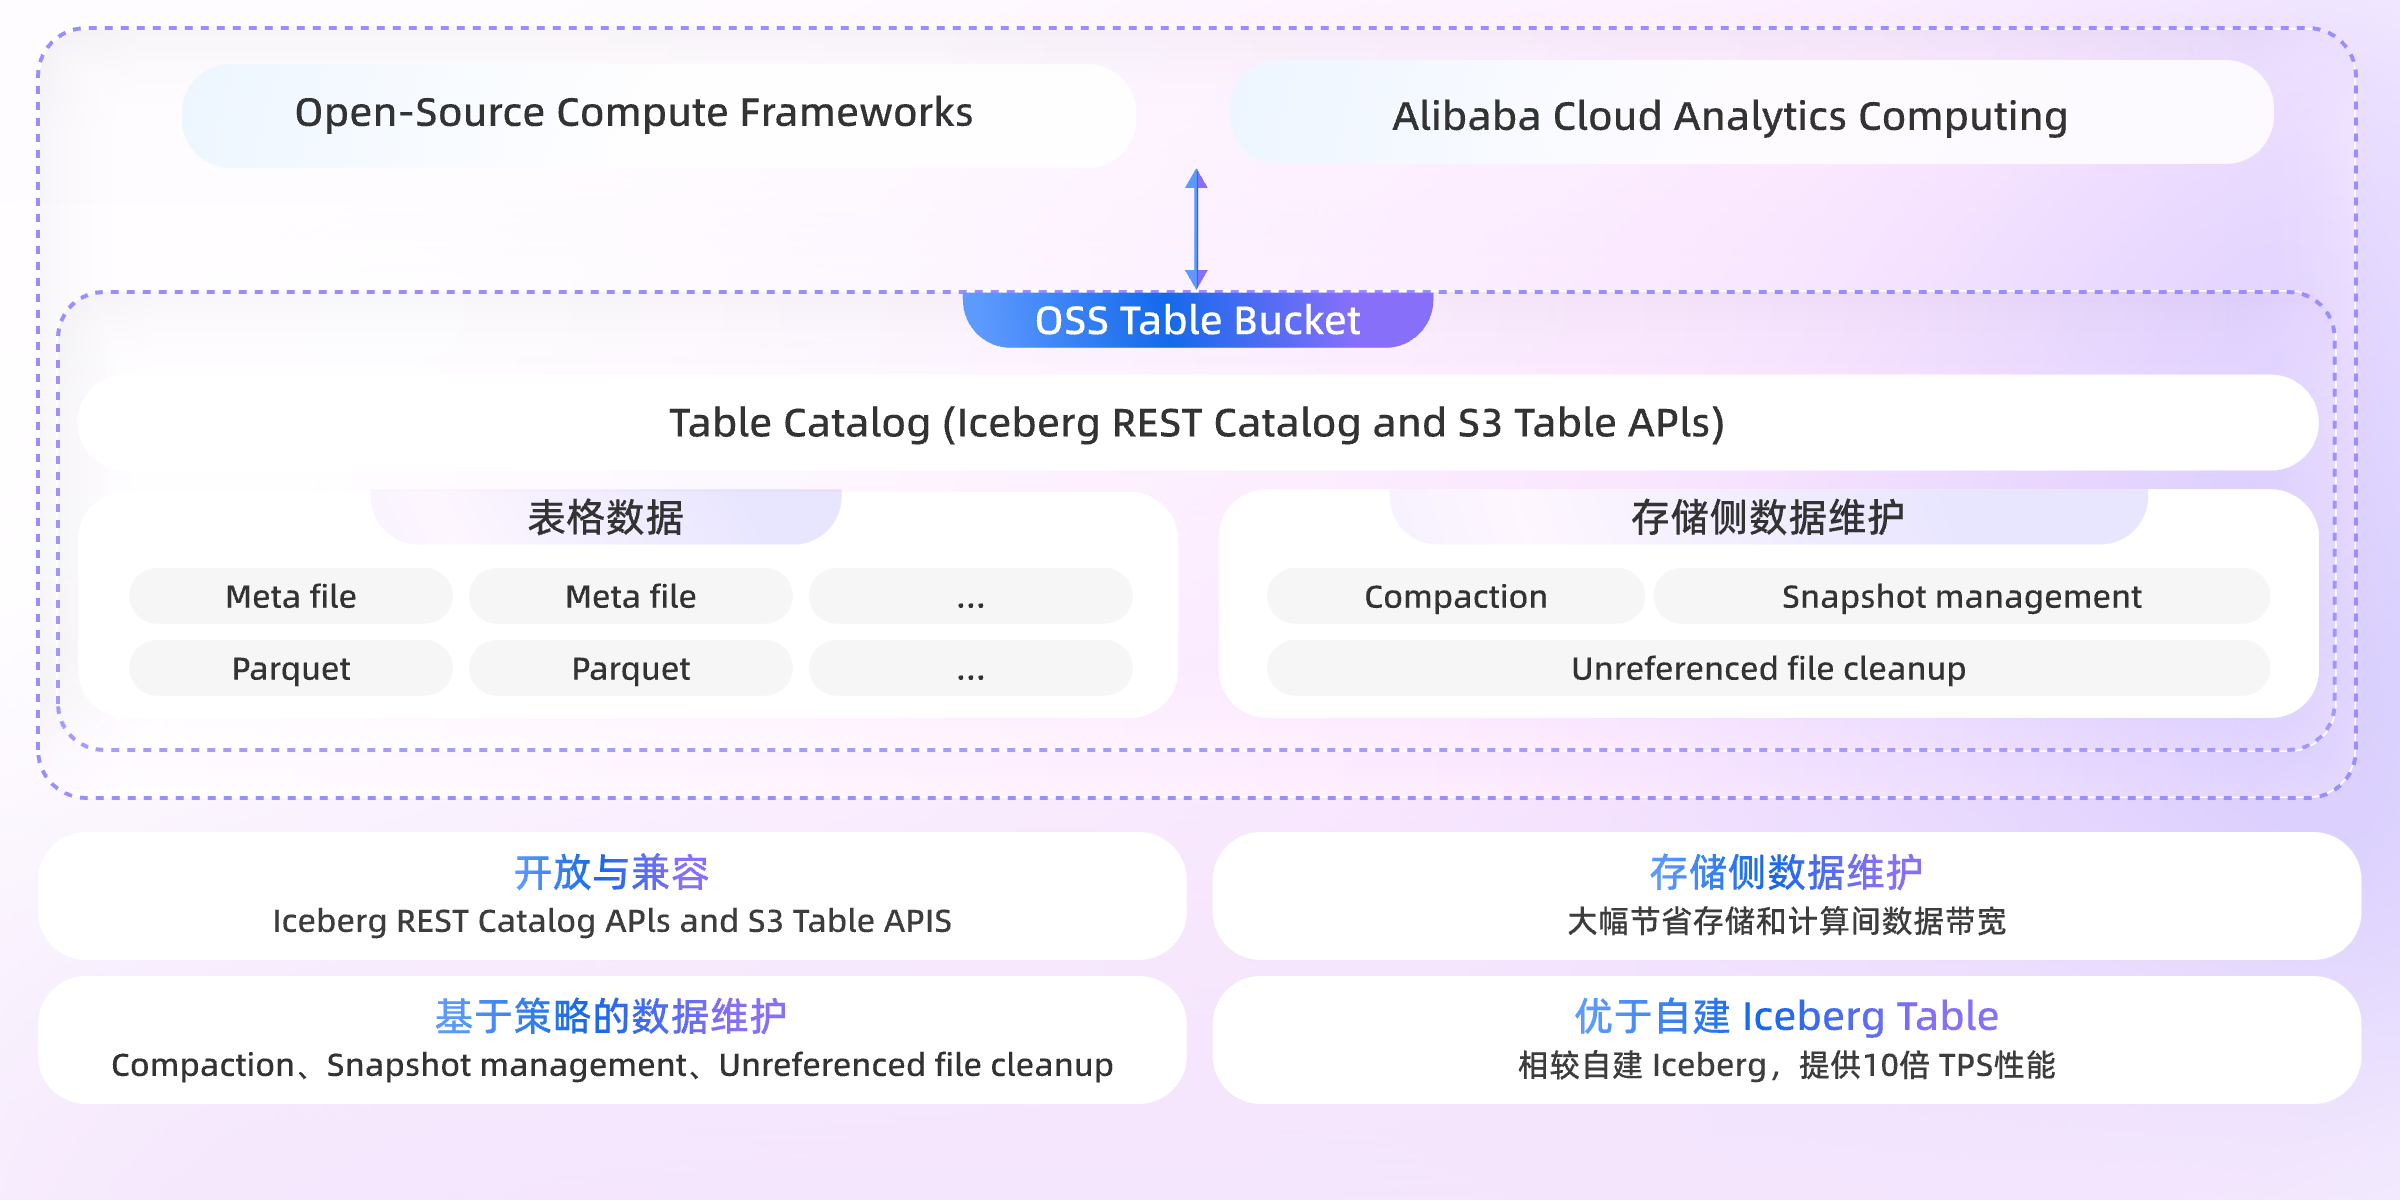
Table Bucket 是 OSS 面向海量结构化数据推出的全托管表格桶类型:
支持 Apache Iceberg V2 & V3 格式规范
融合对象存储低成本海量扩展与传统数仓高性能强事务能力
与对象桶、向量桶协同构建 AI Native 多模态数据统一存储底座。
支持 Apache Iceberg REST Catalog 标准
TPS 提升 10 倍
存储后台自动数据优化

Table Bucket 是 OSS 面向海量结构化数据推出的全托管表格桶类型:
支持 Apache Iceberg V2 & V3 格式规范
融合对象存储低成本海量扩展与传统数仓高性能强事务能力
与对象桶、向量桶协同构建 AI Native 多模态数据统一存储底座。
支持 Apache Iceberg REST Catalog 标准
TPS 提升 10 倍
存储后台自动数据优化
核心优势
平滑迁移,多引擎接入
全面兼容 Apache Iceberg REST Catalog API,任何兼容 Iceberg 的引擎无需改造即可平滑接入。
极致性能
端到端深度优化,TPS 达自建 Iceberg 方案 10 倍以上。
存储侧数据自动优化
存储服务后台自动实现小文件合并、过期快照清理、孤儿文件移除,大幅节约计算和存储的带宽消耗。
开放与数据主权
开放 Iceberg 和 Parquet数据格式,避免厂商锁定。数据文件存储于用户数据桶中,保障数据主权。
简化数据治理和安全管理
OSS对象桶+向量桶+表格桶共享账号权限体系,大幅简化数据管理。
场景应用
现代化湖仓分析
将自建Iceberg 表无缝迁移至 OSS Table Bucket,无需改变计算引擎使用习惯,自动获得 Compaction、快照管理、孤儿文件清理等表维护能力,事务 TPS 较自建方案提升 10 倍以上,大幅提升企业数据分析效率。
AI 训练与 RAG 检索
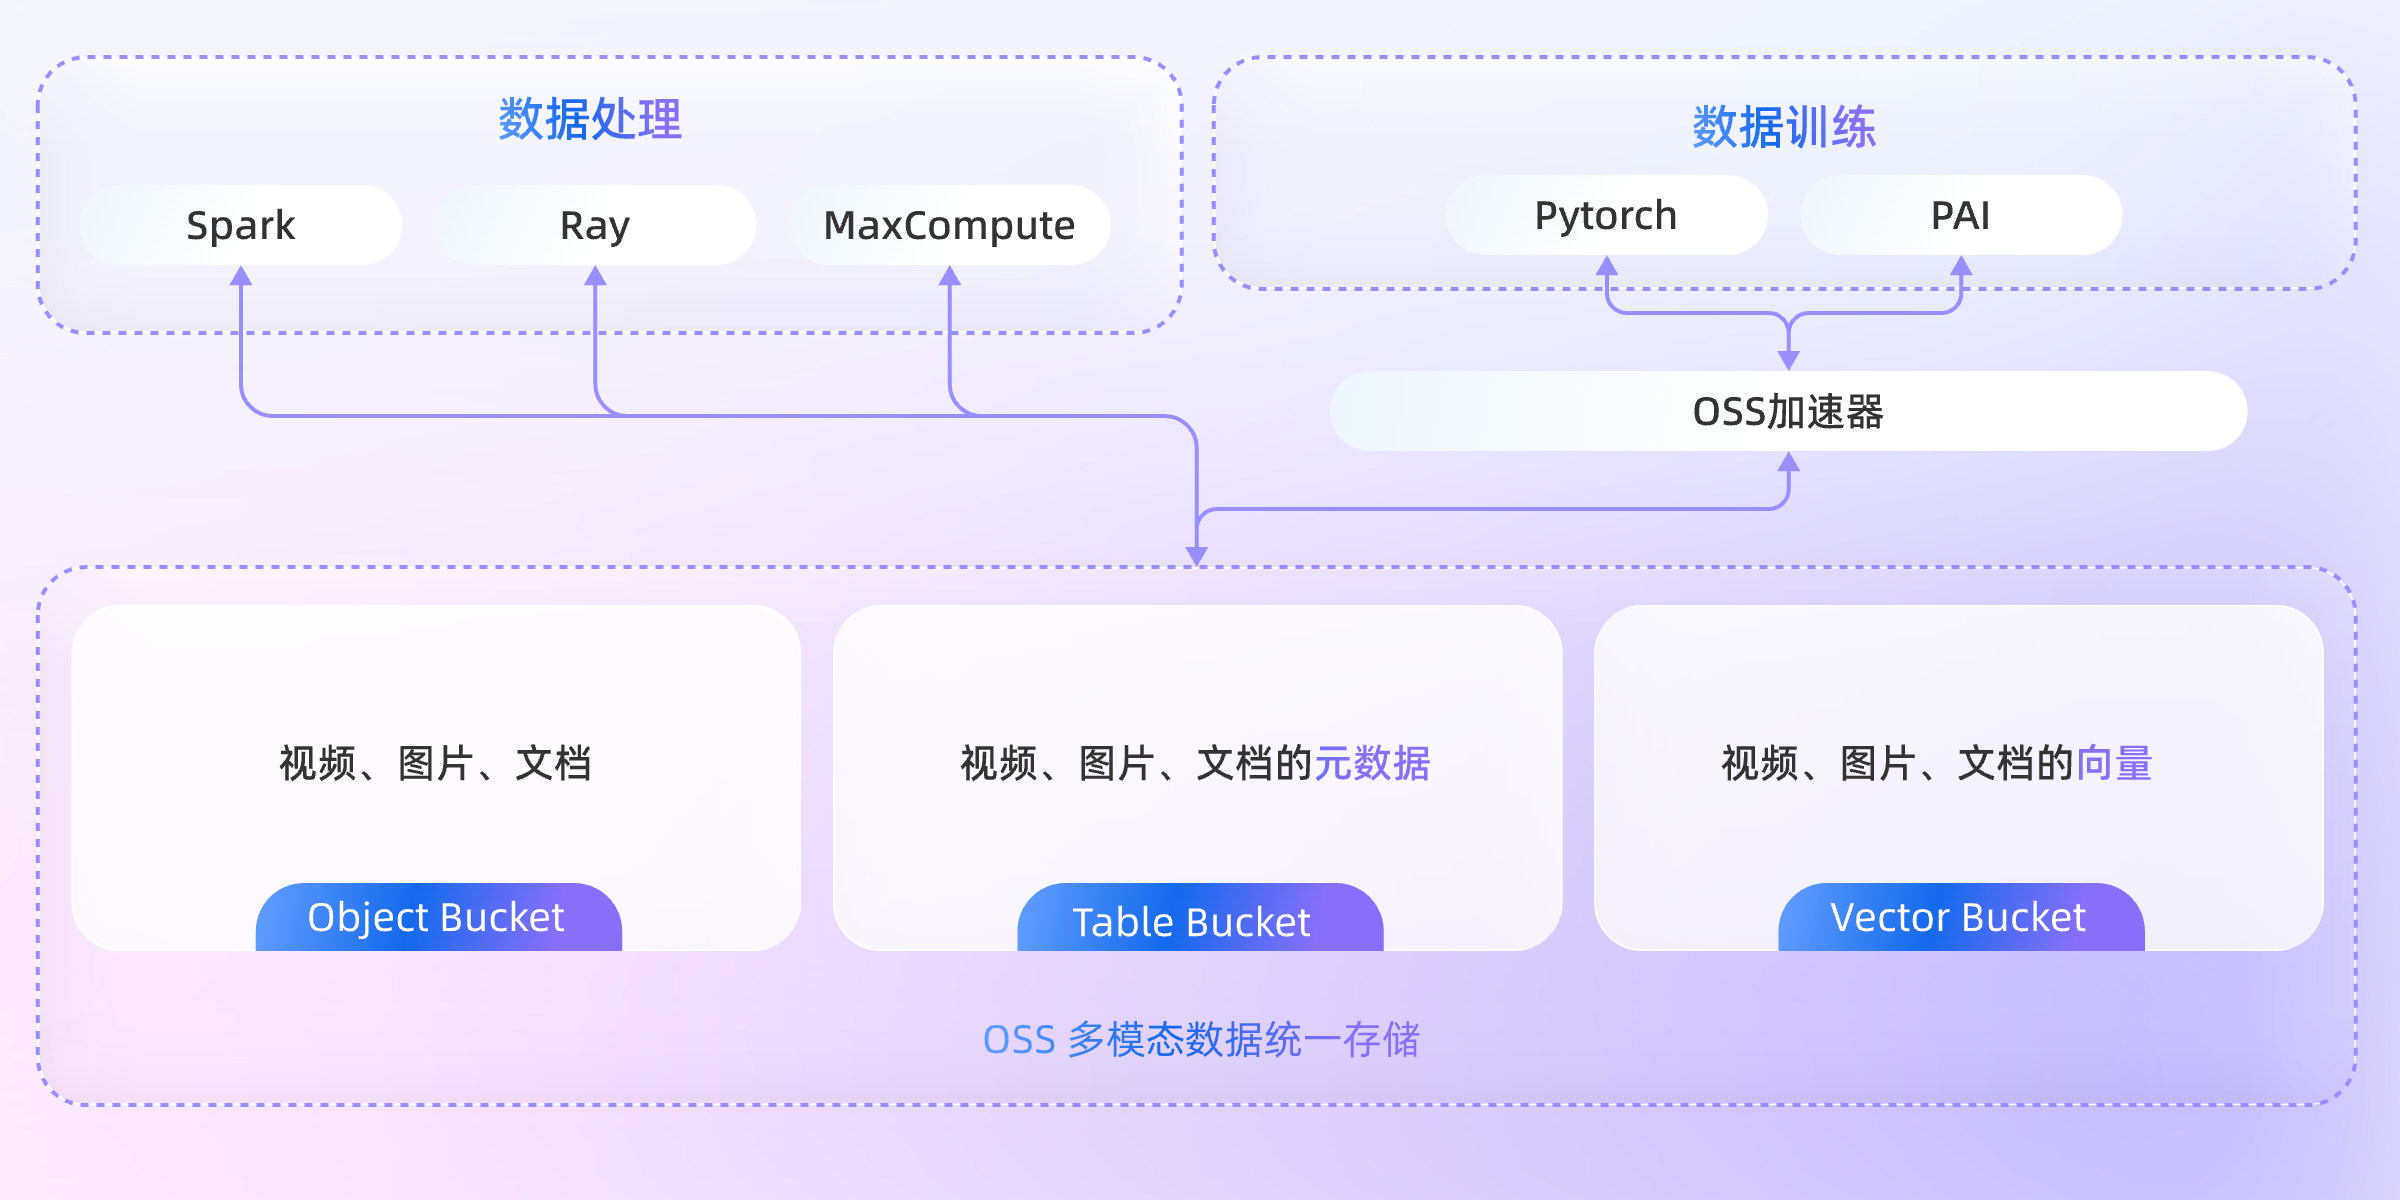
原始图片/视频存于对象桶,Embedding 与召回索引落入向量桶,标注信息与样本元数据由 Table Bucket 统一管理,三桶共享账号与权限,实现训练样本极速筛选与版本回溯。
流式数据零运维入湖
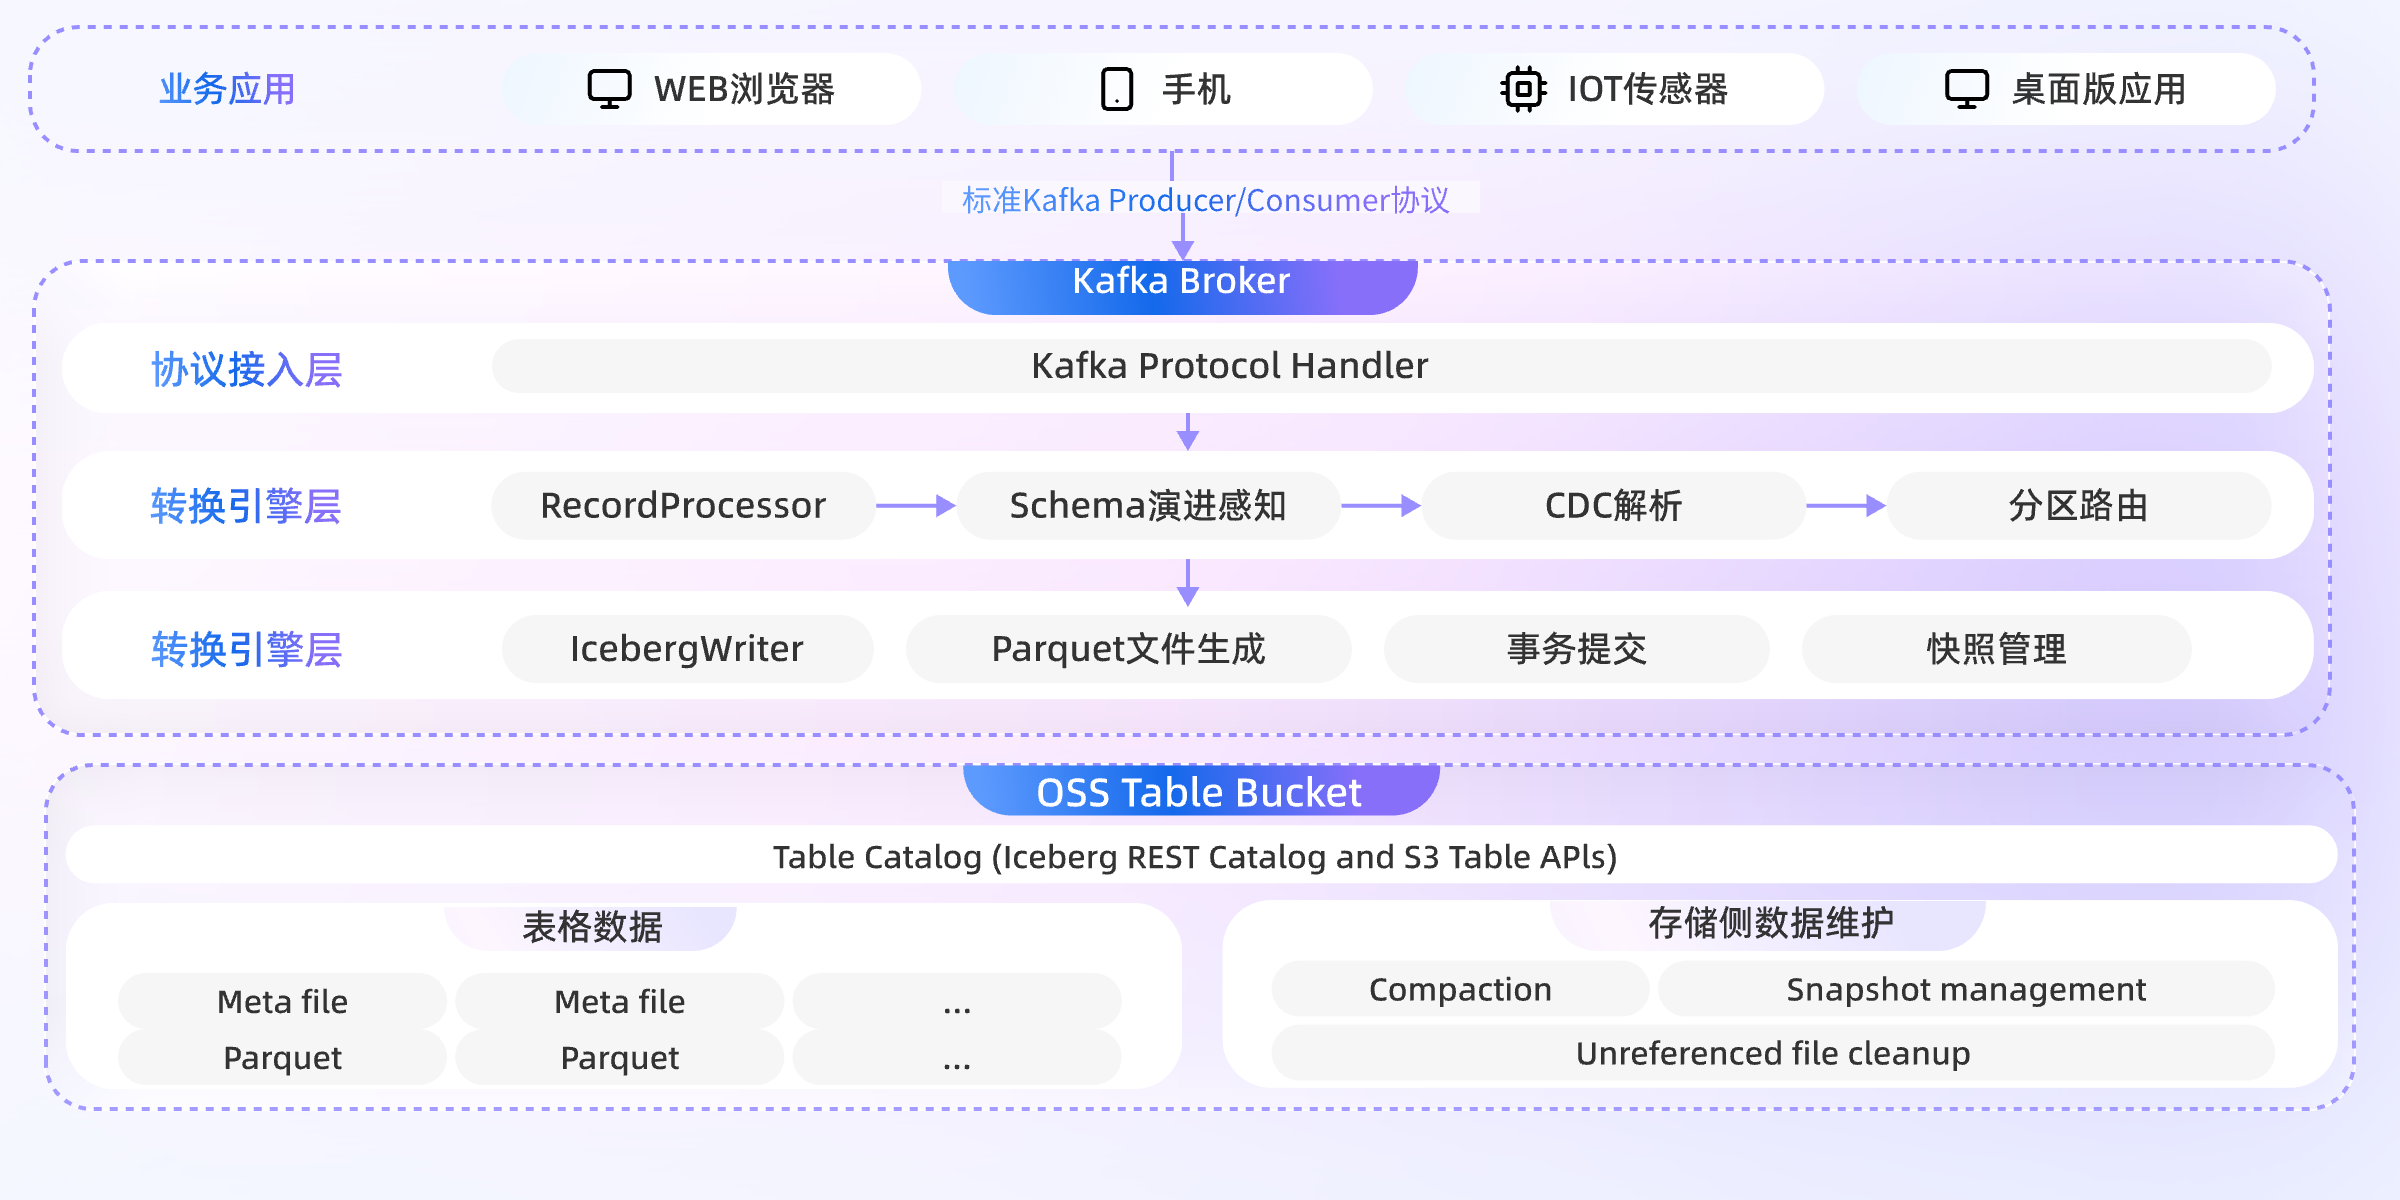
云消息队列 Kafka 版直写 OSS Table Bucket,无需部署外部计算任务,依托 Exactly-once 语义保障数据零丢失零重复,大幅简化实时入湖架构与运维成本。
数据科学与 Notebook 自助分析
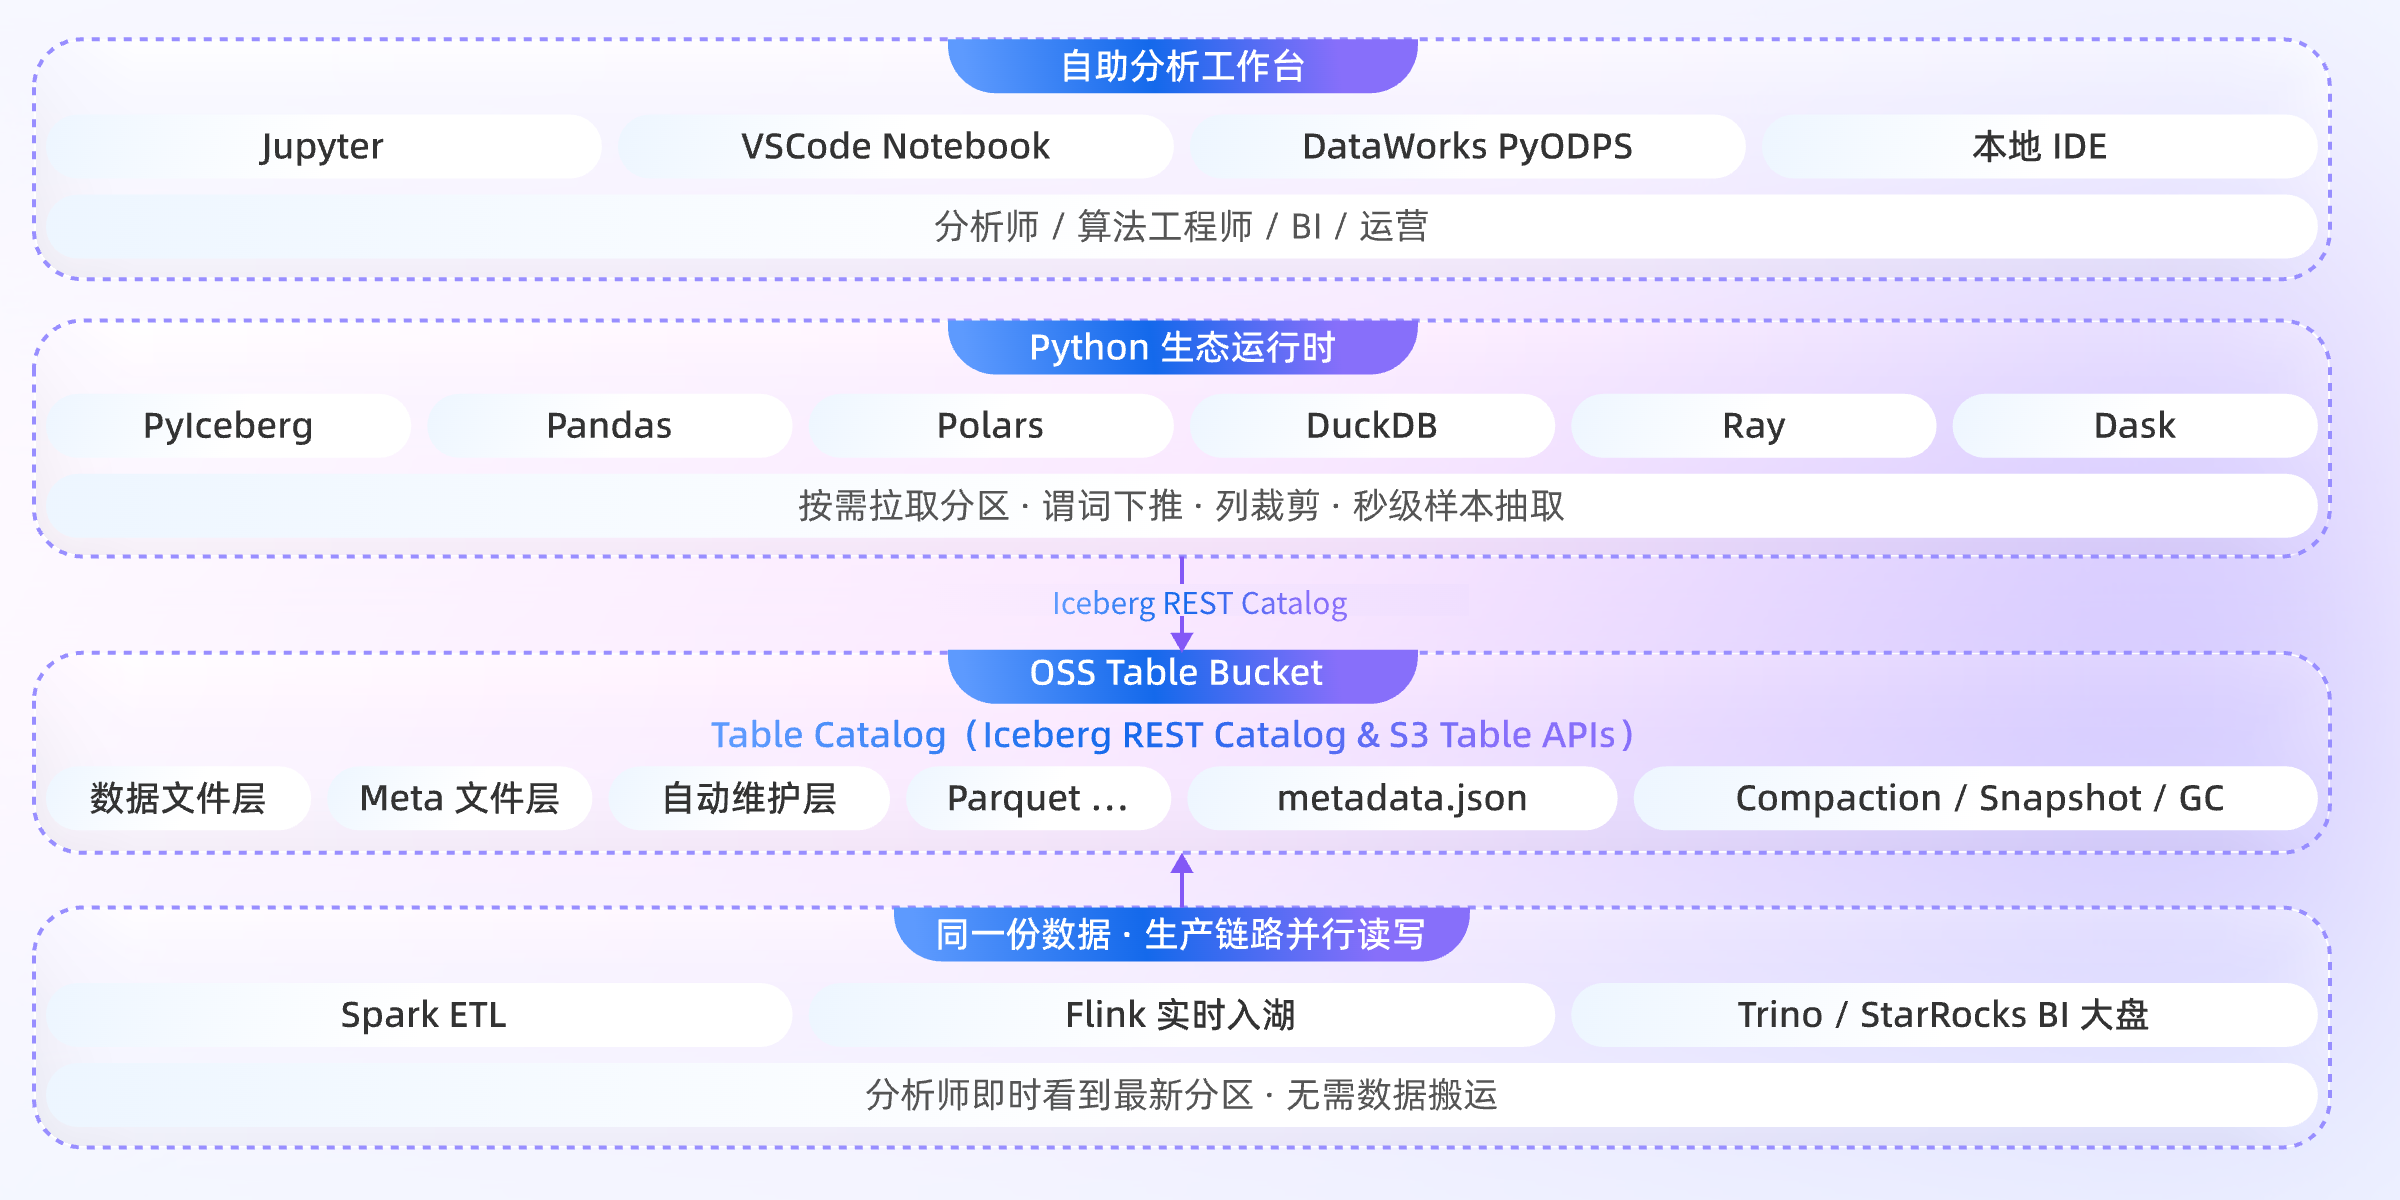
数据分析师与业务 BI 通过 PyIceberg + Pandas / Polars / DuckDB 在本地或 Notebook 中直读 OSS Table Bucket,按需完成特征探查、样本抽取,与生产湖仓共用同一份数据。