开服动态
灵骏真武 M890 超节点实例Day0 适配 Kimi K3.1 Pro,中卫地域开服
真武 PPU 云服务

真武 PPU(Parallel Processing Unit)一款为AI应用加速的芯片,具有高易用性,适用于各类大模型和传统模型的训练及推理场景。它支持主流AI框架和深度学习模型,提供编译器和多种开源加速库,同时配备完整的工具链,帮助您快速、低成本地迁移应用。PPU拥有自研的软件栈,通过 PPU SDK 能够最大化产品算力,显著提升计算效率。真武 PPU 在阿里云实现多个万卡集群部署。依托‘大模型+云+芯片’全栈AI能力,阿里云服务了小鹏汽车、新浪微博等 650+ 多家客户。

Qwen 3
快速部署Qwen 3.8 27B、2.4T、Flash-Next 等模型

Kimi
PD 分离部署 Kimi K3,K3.1 Pro 万亿参数MoE模型,支撑长上下文推理

DeepSeek
PD 分离部署DeepSeek V4 Flash 与 Pro 最新模型

GLM
部署 GLM 5.2/5.3 及 5.3 flash
支持多种 AI 负载,包括预训练、后训练及推理场景,完全兼容 Qwen、LLaMa 等常见开源大模型,支持 Megatron、DeepSpeed、vLLM 等常见训练、推理框架无缝迁移。

版本 | |||
|---|---|---|---|
定位 | 高易用训推一体 AI 芯片 | 全场景训推一体 AI 芯片 | 下一代训推一体 AI 芯片 |
使用场景 | 广泛适用于各类大模型的训练与推理,如自动驾驶主流模型、生成类模型、多模态模型、感知类模型、搜推广模型等 | 广泛适用于各类大模型的训练与推理,覆盖从高精度计算到低精度推理的全场景需求 | 在大幅提升算力密度的同时显著降低推理成本,可应用于高精度训练、低精度和超低精度推理的全场景 |
单卡内存 | 96 GB | 96 GB/144 GB | 216 GB |
片间互联带宽 | 700 GB/s | 800 GB/s | 1200 GB/s |
特性 | ● 高带宽、低延迟片间互联技术 ICN
● 高速互联能力聚合整机 16 卡高算力
● 结合通信库提供灵活的 EP/TP/DP 等并行策略
● 源代码级别编译能力、提供软件栈统一编程接口
● 全面兼容主流AI生态,业务迁移零代码修改 | ● 并行计算架构与片间互联等自研核心模块全面升级
● 支持FP8/FP4低精度算力
● 支持64卡全带宽互联
● 源代码级别编译能力,提供软件栈统一编程接口
● 全面兼容主流AI生态,业务迁移零代码修改 |
● 深度迭代自研并行计算架构
● 3 倍性能提升
● 千卡全带宽 Scale-Up 互联,百 TB 级别统一显存
● 支持FP8/FP4低精度算力
● 全面兼容主流AI生态,业务迁移零代码修改
|
可用情况 | 北京、杭州、上海、乌兰察布等区域 | 乌兰察布(可用区 D),中卫(邀测中),通过灵骏超节点实例提供 | 尽请期待 |
原生支持 vLLM、SGLang 等主流推理引擎,并提供自研 HolmesLLM 专用推理框架,提供 acext 算子库,结合大容量内存,为MoE、int8等推理场景提供针对性优化,以实现更高的吞吐与更低的时延。
通过人工智能平台 PAI 与 容器计算服务 ACS,可按需构建单机多卡、多机多卡模型后训练环境,搭配灵活、高性能的存储与网络方案,通稿使用您要求的训练数据,支持 Finetune 以及 Roll-out 强化学习集群建设,对模型进行后训练。
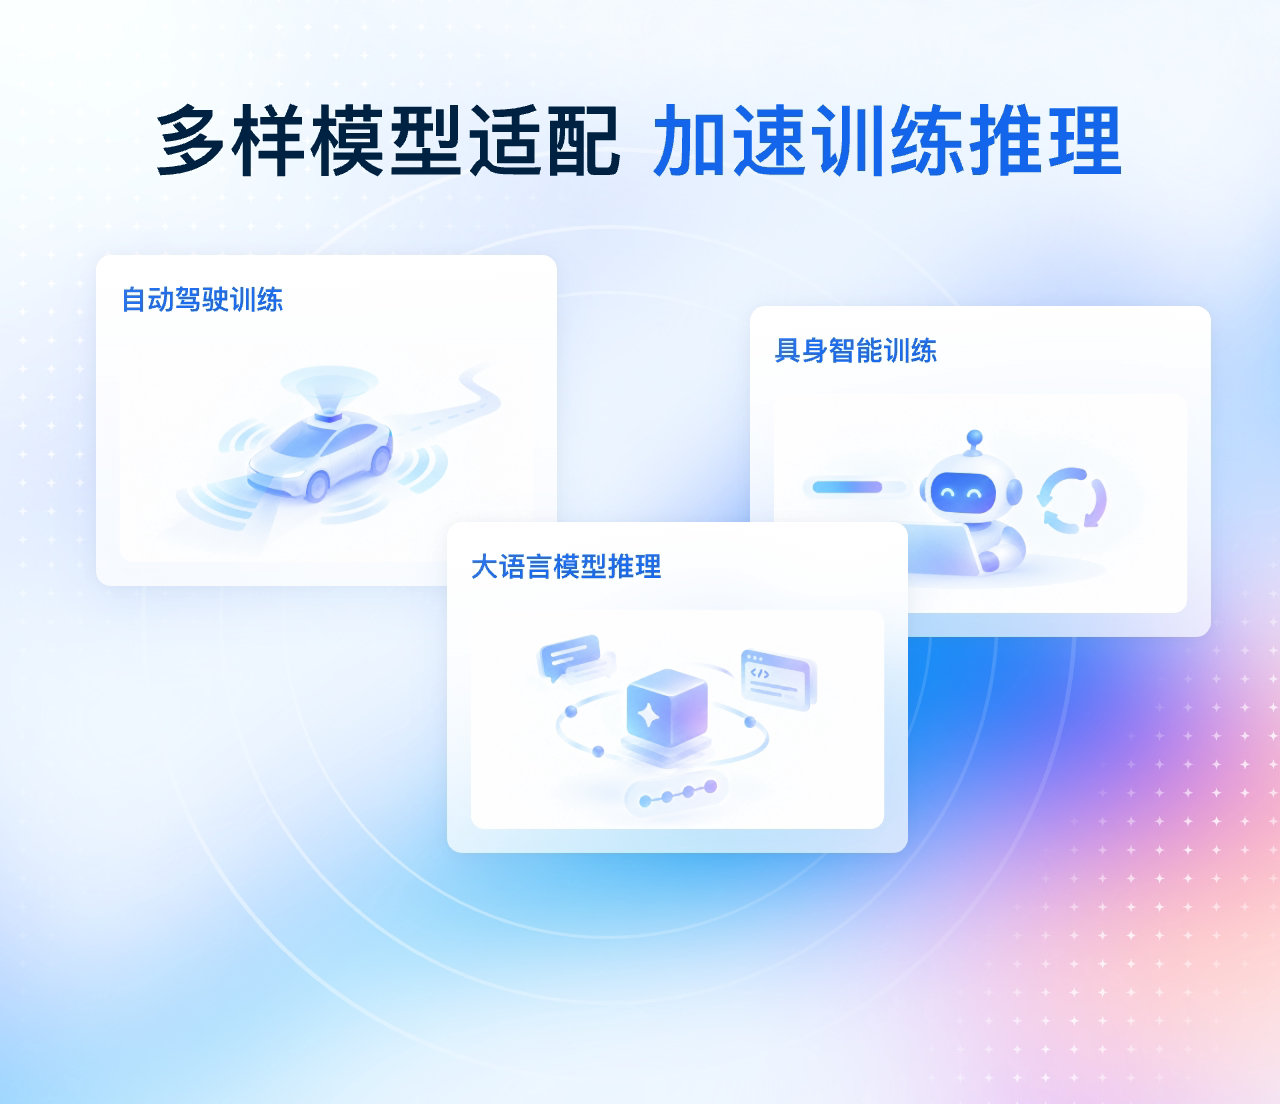
真武 PPU 通过长期生产实践,已验证兼容 50+ 自动驾驶领域常见模型,能够支持如感知模型、预测模型、端到端模型等多种模型架构的模型训练与推理。
您可以通过多样云产品进行部署,例如您需要完全掌控技术栈,可以选择智能计算灵骏真武超节点实例,如果您需要编排大规模 AI 工作负载,可以通过容器计算服务,获得开箱即用的算力与弹性可扩展能力,或直接一步使用人工智能平台PAI,获得一站式的平台体验。
灵骏真武超节点实例,提供 GP9A 与 GP9AS 两款实例,提供64卡, 9TB 与 6TB 显存,已适配包括Qwen 3.8、Kimi、DeepSeek 多样规格的模型权重。